
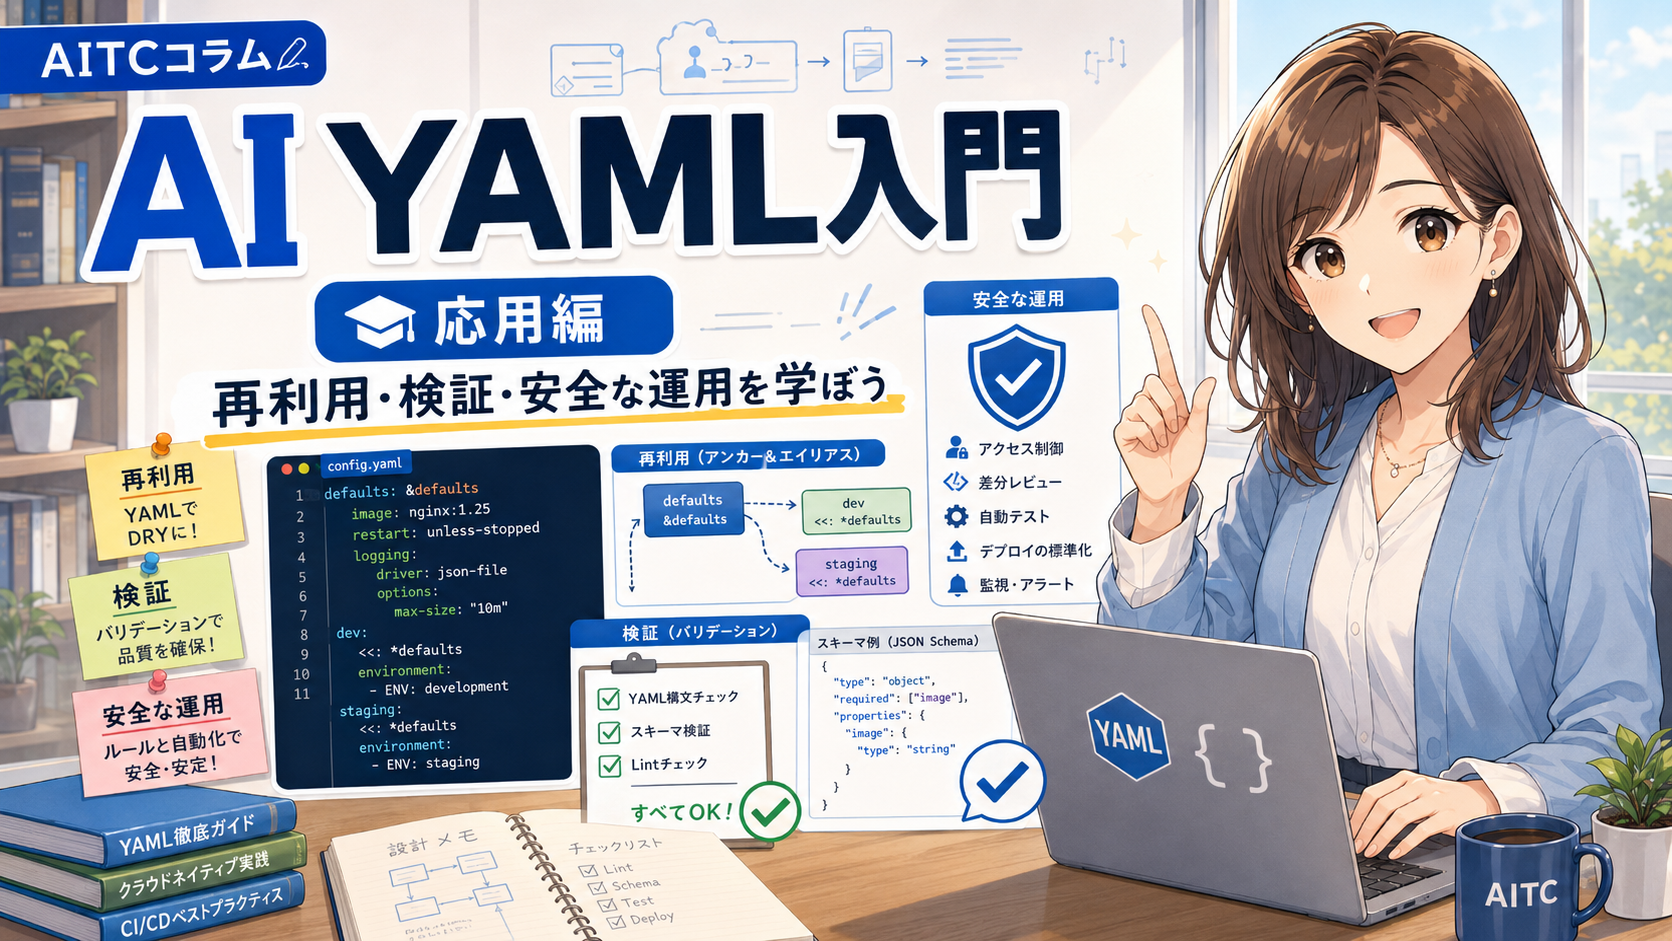
AI YAML入門 応用編 再利用・検証・安全な運用を学ぼう
 fukayayuji
はじめに
AITCセンター長の深谷です。
前回の記事「AI YAML入門 基礎編――基本文法を実務で使ってみよう」では、製造設備の異常対応ルールを題材に、YAMLの基本文法を紹介しました。
Mappingで項目と値を対応付け、Sequenceで複数の症状や確認項目を並べ、インデントで階層を表す。さらに、文字列、数値、Boolean、`null`、複数行文字列の`|`と`>`を使い分けることで、1件の異常対応ルールを、人にもAIにも読み取りやすい形に整理しました。
しかし、実務では「YAMLとして正しく書けた」だけでは十分ではありません。
異常対応ルールが10件、100件と増えてくると、次のような課題が出てきます。
- すべてのルールに同じ安全条件を書くのが大変
- 共通ルールを修正した際に、変更漏れが起きる
- YAMLのバージョンやパーサーによって、値の解釈が変わる
- 必須項目の欠落や、重大度の表記揺れを見逃す
- AIが生成したYAMLを、安全にシステムへ取り込めるか不安
そこで応用編では、前回作成した異常対応ルールを、複数設備・複数アラームへ展開した事例を紹介します。
アンカー`&`とエイリアス`*`による再利用、`---`を使ったドキュメントの区切り、`|-`や`>+`による改行制御、YAML 1.1と1.2の違い、LintとJSON Schemaによる検証、安全なロードまでを扱います。
本記事の到達点は、単に複雑なYAMLを書けるようになることではありません。
「複数の業務ルールを、再利用可能で、検証可能で、安全に運用できるデータとして管理する!」
これが、YAMLをAI Ready Dataとして実務で活用するための重要な一歩です。
基礎編の1件のルールを、複数ルールへ発展させる
基礎編では、画像検査装置`Vision-02`でアラーム`E231`が発生した場合のルールを作成しました。
応用編では、これに搬送モーターの過負荷アラーム`E410`を加えます。さらに、どちらのルールにも共通する安全条件と連絡条件を定義し、重複記述を減らします。
まずは完成イメージを見てみましょう。
%YAML 1.2---metadata: schema_version: "1.0" updated_at: "2026-08-02" owner: 設備保全部門common_safety: &common_safety human_approval_required: true prohibited_actions: - 安全装置を解除する - 稼働中の装置内部に入るdefault_escalation: &default_escalation required: true contact: 設備保全部門 timeout_minutes: 15rules: - id: RULE-E231 tags: [camera, image_inspection] equipment: id: Vision-02 name: 画像検査装置 line: Line-A alarm: code: E231 severity: high automatic_stop: true safety: *common_safety symptoms: - 画像を取得できない - 判定結果が連続してNGになる checks: - order: 1 item: カメラ接続 expected: connected - order: 2 item: 装置温度 threshold: {operator: "<=", value: 70.0, unit: "°C"} response: |- 装置を安全停止する。 カメラケーブルと電源状態を確認する。 復旧しない場合は保全部門へ連絡する。 escalation: *default_escalation - id: RULE-E410 tags: [motor, conveyor] equipment: id: Conveyor-01 name: 搬送コンベア line: Line-A alarm: code: E410 severity: high automatic_stop: true safety: *common_safety symptoms: - 搬送モーターが停止する - 過負荷警告が表示される checks: - order: 1 item: 搬送物の詰まり expected: なし - order: 2 item: モーター電流 threshold: {operator: "<=", value: 8.0, unit: A} response: |- コンベアを安全停止する。 搬送物の詰まりとモーターの状態を確認する。 原因を除去できない場合は保全部門へ連絡する。 escalation: *default_escalation
基礎編と比べると、`&common_safety`、`*common_safety`、`|-`、`[...]`、`{...}`、`%YAML 1.2`、`---`などの記法が増えています。
一つずつ見れば、決して難しいものではありません。大切なのは、文法として書けるか?だけでなく、どの機能を実務で使い、どの機能は自分たちの業務では利用しなくて良いか?まで理解することです。
アンカー`&`とエイリアス`*`:共通ルールを再利用する
複数の異常対応ルールに、同じ安全条件を設定したい場合を想定します。
safety: human_approval_required: true prohibited_actions: - 安全装置を解除する - 稼働中の装置内部に入る
この記述を10件のルールへコピーすると、1か所を変更した際に、残りの9か所も修正しなければなりません。修正漏れが起きれば、同じ種類のルールなのに安全条件が異なる状態になります。
そこで使えるのが、アンカーとエイリアスです。
アンカー`&`で、再利用するデータに名前を付ける
common_safety: &common_safety human_approval_required: true prohibited_actions: - 安全装置を解除する - 稼働中の装置内部に入る
`&common_safety`がアンカーです。直後にあるMappingへ、`common_safety`という名前を付けています。
アンカー名はデータのキーとは別物です。`common_safety:`はYAMLデータ上のキー、`&common_safety`は同じドキュメント内から参照するための名前です。
エイリアス`*`で、アンカーを参照する
common_safety: &common_safety human_approval_required: true prohibited_actions: - 安全装置を解除する - 稼働中の装置内部に入るrules: - id: RULE-E231 safety: *common_safety - id: RULE-E410 safety: *common_safety
`*common_safety`がエイリアスです。これにより、2つのルールから同じ安全条件を参照できます。
アンカーは`&`で名前を付け、エイリアスは`*`で参照する、と覚えると分かりやすいでしょう。まとめると、
| 記法 | 役割 | 例 |
|---|---|---|
&name |
ノードに名前を付ける | &common_safety |
*name |
名前を付けたノードを参照する | *common_safety |
アンカーは、同じドキュメント内で先に定義する
エイリアスは、先に登場したアンカーを参照します。次のように、定義前のアンカーを参照してはいけません。
# 避ける例rule: safety: *common_safetycommon_safety: &common_safety human_approval_required: true
実務では、`common_safety`や`default_escalation`のような共通定義をファイルの前半に置き、その後に個別ルールを並べるようにしましょう。
また、アンカーの有効範囲は1つのYAMLドキュメント内です。後ほど説明する`---`でドキュメントを分けると、前のドキュメントのアンカーを次のドキュメントから参照することはできません。
Flow Style:短いリストやMappingを1行にまとめる
基礎編では、インデントを使う方法を紹介しました。
tags: - camera - image_inspection
これはBlock Styleと呼ばれる方法で、改行とインデントを使って、階層構造を表現する書き方です。
実は、YAMLには、角括弧`[]`や波括弧`{}`を使い、JSONに近い形で書くFlow Styleもあります。
tags: [camera, image_inspection]threshold: {operator: "<=", value: 70.0, unit: "°C"}
| 項目 | Block Style | Flow Style |
|---|---|---|
| 記法 | 改行とインデント | {}、[]、カンマ |
| 見た目 | YAMLらしい | JSONに近い |
| 可読性 | 複雑なデータでも読みやすい | 短いデータならコンパクト |
| 主な用途 | 設定ファイル、業務ルール | 座標、短いリスト、簡単なパラメータ |
| 注意点 | インデントを正しくそろえる | 長くなると読みにくい |
Flow Styleは短いデータをコンパクトにできますが、項目が増えると読みにくくなります。
# 読みにい例rule: {id: RULE-E231, equipment: {id: Vision-02, line: Line-A}, alarm: {code: E231, severity: high}}
業務ルール全体をFlow Styleで1行に詰め込むのはおすすめしません。タグや小さな閾値のように、1行で見渡せる範囲に限定するとよいでしょう。
実業務では、チーム内で「Sequenceは3要素までFlow Styleを許可する」「主要なMappingはBlock Styleにする」といったルールを決めておきましょう。
Chomping Indicator:複数行文字列の末尾改行を制御する
基礎編では、改行を保持する`|`と、改行をスペースへ畳む`>`を紹介しました。
実務では、末尾の改行が不要なプロンプト、コマンド、定型メッセージをYAMLへ格納することがあります。その場合に使えるのが、Chomping Indicatorです。
`-`は末尾の改行を取り除く
response: |- 装置を安全停止する。 カメラ接続を確認する。
`|-`は、本文中の改行を保持しながら、文字列末尾の改行を取り除きます。
AIへのプロンプト、APIへ送る本文、文字列の完全一致を行うテストデータなど、末尾改行の有無が結果へ影響する場面で便利です。
`>-`なら、行の折り返しを基本的にスペースへ変換し、さらに末尾改行を取り除きます。
summary: >- 画像検査装置の接続状態を確認し、 復旧しない場合は保全部門へ連絡する。
`+`は末尾の改行をすべて保持する
message: |+ 点検を完了しました。
`|+`や`>+`は、末尾にある複数の改行も保持します。整形済みテキストなどでは意味がありますが、設定や業務ルールでは必要になる場面は多くありません。
使い分けを整理すると、次のようになります。
| 記法 | 本文中の改行 | 末尾の改行 |
|---|---|---|
| |
保持する | 1つ残す |
|- |
保持する | 取り除く |
|+ |
保持する | すべて残す |
> |
基本的にスペースへ畳む | 1つ残す |
>- |
基本的にスペースへ畳む | 取り除く |
>+ |
基本的にスペースへ畳む | すべて残す |
通常の業務ルールでは、手順は`|-`、長い説明は`>-`を基本にすると、意図しない末尾改行を避けやすくなります。
`---`と`...`:YAMLドキュメントの開始と終了を示す
YAMLでは、1つのファイルを「ストリーム」、その中に含まれる個々のデータを「ドキュメント」として扱います。
簡単に言うと、YAMLでは 1つのファイルの中に、複数の独立したデータのまとまりを入れられるということです。
たとえるなら、
- ストリーム:1冊のファイル
- ドキュメント:その中に収録された個別の章・書類
という関係です。
`---`はドキュメントの開始、`...`はドキュメントの終了を示します。
---id: RULE-E231alarm_code: E231...
1ファイルに1ドキュメントだけを置く場合、通常は`---`と`...`を省略できます。ただし、ドキュメントの開始を明確にしたい場合や、Lintルールで必須にしている場合は`---`を付けます。
1ファイルに複数ドキュメントを格納する
`---`を繰り返すと、1つのファイルに複数のドキュメントを格納できます。
---id: RULE-E231equipment_id: Vision-02alarm_code: E231...---id: RULE-E410equipment_id: Conveyor-01alarm_code: E410...
ただし、複数ドキュメントを使うかどうかは、業務システムとしてどう扱うか?で決めるべきです。
さらに、前述したアンカーはドキュメントをまたいで共有できません。
異常対応ルールの一覧を管理するだけなら、本記事の完成例のように、1ドキュメント内の`rules`をSequenceにする方が、検証や共通定義の再利用が容易です。
rules: - id: RULE-E231 alarm_code: E231 - id: RULE-E410 alarm_code: E410
`%YAML`と`%TAG`:ディレクティブは処理系への指示
YAMLには、`%`で始まるディレクティブがあります。YAMLのディレクティブとは、実際のデータを書く前に、YAMLパーサーへ「このドキュメントは、こういうルールで読んでください」と伝えるための指定です。
%で始まり、YAML 1.2では次の2種類があります。
%YAML:使用するYAMLのバージョンを指定する%TAG:タグの省略記法を定義する
たとえると、本文の前に置く「読み方の注意書き」のようなものです。
`%YAML`でバージョンを明示する
%YAML 1.2---id: RULE-E231enabled: true
`%YAML 1.2`は、このドキュメントがYAML 1.2に従うことを示します。
ここで指定するのは`1.2`であり、`1.2.2`ではありません。YAML 1.2.2はYAML 1.2仕様の改訂版ですが、ディレクティブで書くバージョンは`%YAML 1.2`です。
ディレクティブを書いた場合、その直後には`---`が必要です。また、同じストリーム内の次のドキュメントで新しいディレクティブを指定する場合、前のドキュメントを`...`で明示的に終了させる必要があります。
%YAML 1.2---id: RULE-E231...%YAML 1.2---id: RULE-E410
`%TAG`でタグの接頭辞を定義する
`%TAG`は、独自タグで使うURIの接頭辞に短い名前を付ける機能です。
%TAG !maint! tag:example.com,2026:maintenance/---timeout: !maint!minutes 15
この例では、`!maint!minutes`というタグを、アプリケーション固有の型へ対応付けようとしています。
ただし、受け取り側がそのタグの意味や変換方法を実装していなければ、ロードに失敗します。独自タグはデータの可搬性を下げ、後述する安全なロードにも関係します。
多くの業務データでは、独自タグを使わず、次のように通常のMappingで表した方が分かりやすく安全でしょう。
timeout: value: 15 unit: minutes
YAML 1.1と1.2:見た目が同じでも型が変わる
YAML運用で特に注意したいのが、YAML 1.1と1.2の型解決の違いです。
例えば、次のYAMLを見てください。
mode: onanswer: yesequipment_code: 010inspection_date: 2026-08-02
人は、`on`や`yes`を文字列、`010`を設備コード、日付を日付らしい文字列として読むかもしれません。しかし、AIによって、Boolean、数値、日付型などへ解釈される可能性があります。
主な違いを整理すると、次のようになります。
| 値・機能 | YAML 1.1で起き得る解釈 | YAML 1.2 Core Schemaでの基本的な扱い |
|---|---|---|
yes / no |
Boolean | 文字列 |
on / off |
Boolean | 文字列 |
true / false |
Boolean | Boolean |
010 |
8進数として解釈され得る | 10進数の10 |
0o10 |
一般的な8進数記法ではない | 8進数の8 |
| Timestamp | 推奨型として扱われる | Core Schemaの推奨型から削除 |
マージキー<< |
特殊キーとして定義 | 推奨スキーマから削除 |
業務で値の解釈を安定させるには、次のような書き方が有効です。
mode: "on"answer: "yes"equipment_code: "010"inspection_date: "2026-08-02"enabled: true
- 識別子、コード、日付、`yes`や`on`はクォートする
- Booleanは`true`と`false`だけを使う
- 8進数が必要なら、利用環境を確認したうえで`0o`接頭辞を使う
- ファイルに`%YAML 1.2`を書くだけでなく、パーサーの仕様を確認する
実際どうしたら良いか?という質問に対する回答は以下になります。
「YAML 1.2を前提とし、Booleanは`true`または`false`、識別子と日付はダブルクォートで囲む」
YAMLの検証は4層に分ける:構文、表記、構造、業務ルール
YAMLを実際に運用に載せるには、以下4つの検証を分けて考える必要があります。
| 検証層 | 確認すること | 代表的な方法 |
|---|---|---|
| 1. 構文 | YAMLとして読み込めるか | YAMLパーサー |
| 2. 表記 | インデント、重複キー、空白、アンカーなどがルールどおりか | Lint |
| 3. 構造 | 必須キー、型、許容値、配列要素、数値範囲が正しいか | JSON Schema |
| 4. 業務ルール | 項目間の整合、安全条件、現場手順が妥当か | プログラムによる検査と人のレビュー |
YAMLパーサー
YAMLパーサーとは、YAML形式で書かれた文字列を読み取り、プログラムで扱えるデータ構造へ変換する仕組みです。たとえば、YAMLのMappingは辞書やオブジェクト、Sequenceは配列として読み込まれます。
パーサーは、インデントの誤り、コロンの不足、クォートの閉じ忘れなど、YAMLとして解釈できない構文エラーを検出します。ただし、「必須項目が存在するか」「値が業務上正しいか」までは通常判断しません。
Lint
Lintとは、YAMLの書き方があらかじめ定めたルールに沿っているかを機械的に確認する仕組みです。YAML向けのLintツールは、インデントの深さ、行末の空白、重複キー、長すぎる行、不要な空行などを検出します。
YAMLパーサーが「YAMLとして読み込めるか」を確認するのに対し、Lintは「読みやすく、統一された安全な書き方になっているか」を確認します。
JSON Schema
JSON Schemaとは、JSONやYAMLのデータ構造が、あらかじめ定めた設計ルールに合っているかを検証するための仕組みです。YAMLは多くのツールでJSONと同じデータ構造として扱えるため、JSON Schemaを使ってYAMLも検証できます。
たとえば、必須キーが存在するか、値が文字列・数値・Booleanのどれか、許可された値だけが使われているか、数値が指定範囲内か、配列の各要素が正しい構造か、といった条件を確認できます。
YAMLパーサーやLintが主に構文や表記を確認するのに対し、JSON Schemaは「データの形や値が仕様どおりか」を検証します。ただし、複数項目を組み合わせた複雑な業務判断や、現場手順の妥当性までは十分に検証できないため、必要に応じてプログラムによる検査や人のレビューを組み合わせます。
実務での推奨・非推奨を整理する
応用編で扱った機能を、実務での使い方という観点からまとめます。
| 機能 | 実務での位置付け | ポイント |
|---|---|---|
アンカー&・エイリアス* |
条件付きで推奨 | 同一ドキュメント内の明確な共通データに限定する |
マージキー<< |
原則として非推奨 | YAML 1.2の推奨スキーマ外。実装差を生みやすい |
| Flow Style | 短いデータのみ推奨 | タグや小さなMappingに限定し、詰め込みすぎない |
|-・>- |
用途が合えば推奨 | プロンプトや定型文の末尾改行を制御する |
| 複数ドキュメント | ドキュメント数を増やしたくないという方針がある場合 | 1件だけ読むAPIとの取り違えに注意する |
%YAML 1.2 |
方針明示に有効 | 書くだけで処理系の挙動が統一されるとは限らない |
独自タグ・%TAG |
原則として避ける | 専用実装と安全なコンストラクターが必要 |
| YAMLパーサーの選定・バージョン固定 | 推奨 | YAML 1.2への対応状況や、重複キー、タグ、複数ドキュメントなどの挙動を確認し、利用する処理系とバージョンを統一する |
| Lint | 推奨 | 表記揺れ、重複キー、アンカーの問題を検出する |
| JSON Schema | 推奨 | 必須項目、型、許容値、範囲を検証する |
まとめ AI ReadyなYAMLは、書き方より運用設計で決まる
基礎編では、YAMLを使って1件の異常対応ルールを構造化しました。応用編では、そのルールを複数へ展開し、再利用、検証、安全なロードまで扱いました。
生成AIによって、YAMLを作ること自体は簡単になりました。自然言語の手順書や不具合報告から、数秒でYAMLの下書きを作ることもできます。
しかし、本当に価値があるのは、YAMLが生成された瞬間ではありません。
共通ルールを再利用できること。表記や構造を機械的に検証できること。人の承認を経て、安全に業務で利用できること。そして、変更履歴を残しながら継続的に改善できること。そこまで設計して初めて、YAMLはAI Readyな業務データになります。
「AIが読めるデータ」から、「組織として信頼して運用できるデータ」へ。その一段先まで進めることが、AIエージェント時代のデータ整備には求められます。
生成AI活用の成否は、モデル性能だけでは決まりません。現場にある情報資産が、AIにとって読み取りやすく、比較しやすく、検証しやすい形になっているか?に、大きく左右されます。
AI Ready Dataの整備から、RAG、AIエージェント、業務システムとの連携まで、AIを業務に活用したいと考えていらっしゃる方は、ぜひご相談ください。
筆者
AITC センター長
深谷 勇次
