
AIエージェントの次の競争は「ContextOps/コンテキストオプツ」?
 fukayayuji

はじめに
AITCセンター長の深谷です。
AIモデルの推論能力は向上し、一度に読み込める情報量も増え、MCPなどを通じて外部のシステムを利用できるようになりました。
しかし、企業でAIエージェントを本格的に活用しようとすると、AIモデルの性能だけでは解決できない課題に直面します。
例えば、こんな問題です。
- AIが参照した社内規程が、実は古いバージョンだった。
- 営業部門と技術部門で、AIが異なる情報を参照してしまう。
- 社内の業務システムには最新情報があるのに、AIはそれを利用できていない。
- 一度は正しく答えられたAIが、業務ルールの変更後も古い情報をもとに回答してしまう。
これらは、AIモデルを高性能なものに変更するだけでは解決しません。
重要なのは、AIエージェントが業務を実行するときに、必要な情報を、必要なタイミングで、正しい権限のもとで、AIが参照できる状態を作ることです。
今回は、この「ContextOps/コンテキストオプツ」という考え方を紹介しながら、企業がAIエージェントを継続的に活用するために、どのような仕組みを整えるべきなのかを考えてみたいと思います。
Context EngineeringとContextOpsとは?
まず、Context(コンテキスト)とは何でしょうか。
日本語では「文脈」や「状況」と訳されますが、企業のAIエージェントにおけるコンテキストは、単に会話の前後関係を意味するものではありません。
例えば、あるAIエージェントが「この設計変更は、どの法規・規格に影響する?」という質問に回答するケースを考えてみます。
正しく回答するには、設計変更の内容だけでなく、現在適用される法規・規格、社内の設計基準、過去の類似案件、対象製品の仕様など、多くの情報が必要です。さらに、質問者がどの部門に所属しているのか、どの情報を閲覧できるのか、といった条件も考慮する必要があります。
このように、AIが適切に判断するために必要な情報や条件を組み合わせたものが、コンテキストです。
以前、以下のコラムの中で、コンテキストエンジニアリングに関して説明しました。
ハーネスエンジニアリングとコンテキストエンジニアリングとプロンプトエンジニアリングを比較
はじめに 生成AIの活用が企業の現場に広がる中で、最近あらためて注目されている言葉があります。それが「ハーネスエンジニアリング(Harness Engineering)」です。 これ…
 AITC | AI TRANSFORMATION CENTER

コンテキストエンジニアリングは、AIが適切な判断や回答を行えるように、必要な情報や文脈を、適切な形・順序・タイミングでAIに提供するための設計技術です。
そして、ContextOpsは、そのコンテキストを一度作って終わりにせず、ライフサイクル全体を通じて管理・統制・監視・改善し続ける運用の考え方です。
両者の違いを整理すると、次のようになります。
| 観点 | Context Engineering | ContextOps |
|---|---|---|
| 主な目的 | AIに必要な情報や条件を、適切な形・順序・タイミングで届ける | その情報や条件を継続的に正しく保つ |
| 主な活動 | 情報検索、データ統合、ツール連携、コンテキスト設計 | 更新管理、品質評価、権限管理、監視、改善 |
| 時間軸 | 主に設計時・実行時 | 設計時・実行時・運用改善時の全体 |
| 代表的な問い | AIに何を渡せば正しく答えられるか? | その情報は今も正しく、安全に利用できるか? |
ここで重要なのは、Context EngineeringとContextOpsは対立するものではないという点です。
Context Engineeringによって、AIが必要な情報を利用できるようにする。そしてContextOpsによって、その状態を継続的に維持・改善していく。
企業のAI活用には、その両方が必要になります。
RAGを構築しただけでは、ContextOpsにはならない
これまでAITCのコラムでは、企業のRAG活用について、いくつかの記事を書いてきました。
まず、ExcelやPowerPoint、PDFに含まれる情報をAIがどこまで読み取れるのか。
そのExcel、AIはどこまで読めてる? 業務RAGを横長の表と長文セルから考えよう
はじめに AITCセンター長の深谷です。 皆さんの会社にも、こんなExcelはありませんか? どれも、業務ではごく普通に使われているExcelだと思います。そして、こうしたファ…

次に、読み取った情報をもとに、AIが正しく回答できているのか。
そのRAG、本当に正しく答えていますか?~Excel・PowerPoint・PDFを読み取った、その先にある「回答品質」の壁~
はじめに AITCセンター長の深谷です。 前回、前々回のコラムでは、企業に蓄積されたExcelをRAGで活用する方法や、PowerPoint・PDFに含まれる画像、グラフ、表まで理解する…
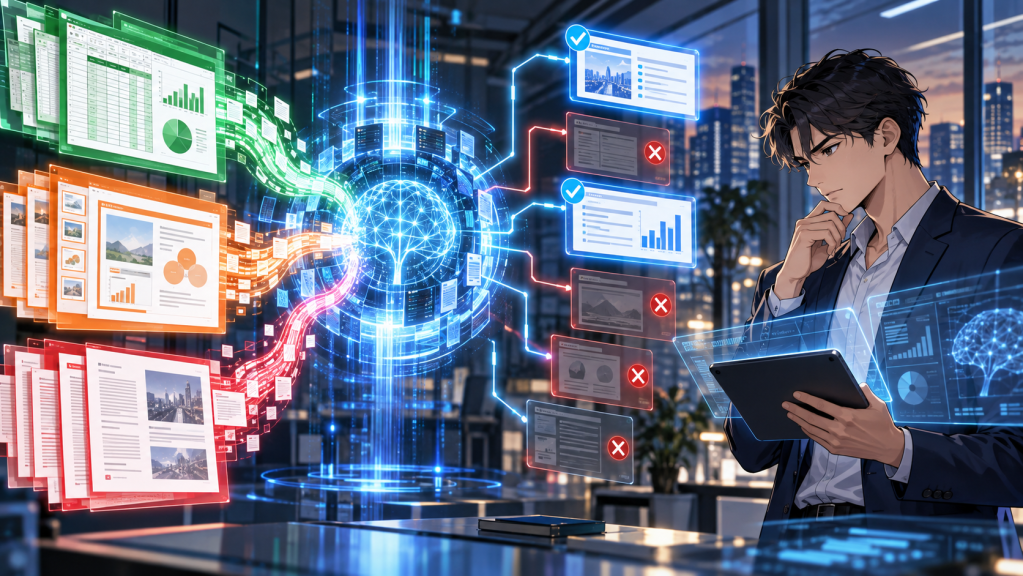
さらに、企業の業務知識を継続的に整備する「ナレッジエンジニア」の重要性についても紹介しました。
AI時代の新職種「ナレッジエンジニア」とは?企業の知識を育て続ける役割
はじめに AITCセンター長の深谷です。 ここ最近、本当に使えるRAGとは?という想いで、3回にわたって記事を書いてきました。 最初の記事では、横長の表や長文セルを持つEx…
こうした取り組みは、ContextOpsを実現するうえでも重要です。しかし、ContextOpsの対象はRAGに登録された文書だけではありません。
Context Engineeringの主な構成要素を以下に示します。
| 構成要素 | 役割 | 企業での具体例 |
|---|---|---|
| RAG | 企業の知識や文書から必要な情報を取得する | 社内規程、設計基準、過去トラブル |
| Function Calls | 外部システムやAPIを利用する | ERP、PLM、CRMから最新情報を取得 |
| Memory Management | 過去のやり取りや業務状態を引き継ぐ | 過去の判断、作業の進捗、継続中のタスク |
| Context Models | 取得した情報を業務上の意味や関係性に沿って統合する | 製品・部品・規格・業務ルールの関係を整理 |
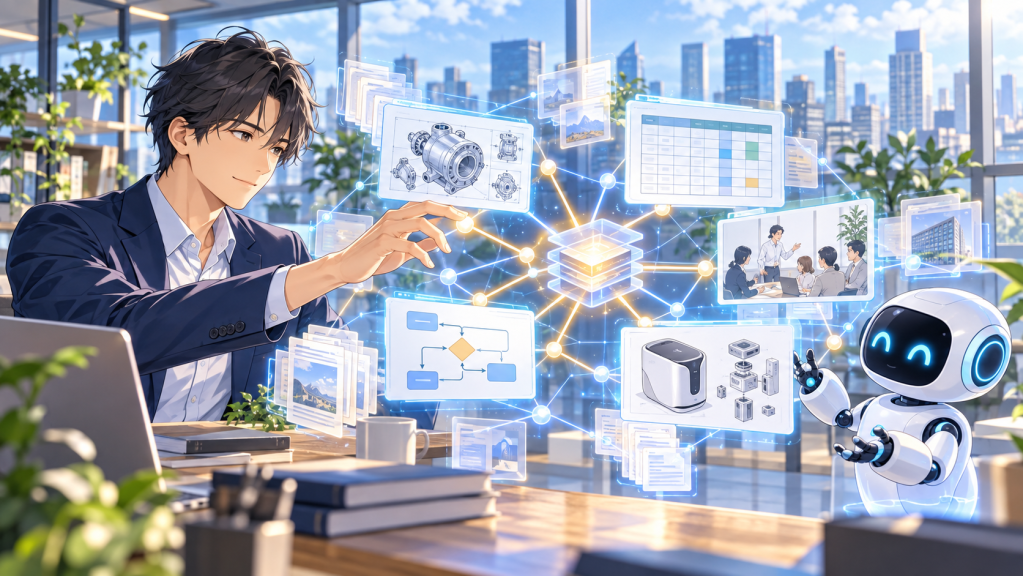
つまり、企業のAIエージェントが使うコンテキストには、文書として蓄積された知識だけでなく、業務システムに存在する最新データや、過去のミーティングやドキュメントなども含まれます。
そしてContextOpsでは、これらの情報が適切に維持されているかを継続的に確認します。
例えば、業務システムのAPIが変更された場合、文書を更新するだけでは不十分です。AIエージェントが正しいAPIを呼び出せることまで確認する必要があります。また、組織変更によってアクセス権限が変わった場合には、AIエージェントから参照できる情報も見直す必要があります。
RAGの運用はContextOpsの重要な一部ですが、ContextOpsはRAGの運用だけにとどまらない。
ここが今回、特にお伝えしたいポイントです。
具体例:設計変更に関係する法規・規格が更新されたら?
少し具体的な業務を考えてみましょう。
ある製造業の設計担当者が、AIエージェントに次のように質問したとします。
「この設計変更は、どの法規・規格に影響する?」
AIエージェントは、社内の設計基準、過去の変更履歴、法規・規格の管理資料、PLMなどに登録された製品情報を参照し、影響する可能性のある法規・規格を整理します。
ここまでは、RAGや業務システム連携によるContext Engineeringの領域です。
では、その数週間後に、関連する社内基準が改訂されたらどうでしょうか。
RAGに古い基準が残っていれば、AIは改訂前の基準をもとに回答してしまいます。
また、最新版の規格が登録されていても、特定の製品には旧版が適用される経過措置が存在することも考えられます。
この場合、単に「最新の文書を検索する」だけでは、必ずしも正しい回答にはなりません。
ContextOpsの考え方では、例えば次のような管理が必要になります。
- 情報の更新: 新しい法規・規格や社内基準が公開されたら、参照する業務ナレッジを更新する。
- 適用条件の管理: いつから、どの製品・部門・業務に適用される情報なのかを明確にする。
- 権限の管理: 利用者が参照できる情報だけをAIに提供する。
- 回答品質の確認: 改訂前後でAIの回答を検証し、想定どおりに変更されているか確認する。
- 変更履歴の管理: どの情報を参照して回答したのか、後から確認できる状態にする。
もちろん、これらをすべて一つのAI製品で実装する必要はありません。法規・規格の原本管理システム、PLM、文書管理システム、AIのナレッジ基盤などを組み合わせて実現することもできます。
重要なのは、それぞれのシステムが持つ情報をAIが適切に利用できるようにし、その状態を継続的に維持することです。
また、法規適合性の最終的な判断をAIだけに任せるのではなく、必要に応じて担当者による確認や承認を組み込むことも欠かせません。
Know Narratorの業務ナレッジを、ContextOpsを支える基盤に
私たち電通総研が提供するKnow Narratorでは、企業内の文書や業務情報を、AIが活用するための「業務ナレッジ」として管理できます。
Know Narratorの強みの一つは、複数の業務ナレッジを横断的に活用できることです。
例えば、設計部門のAIエージェントであれば、設計基準、品質情報、過去トラブル、法規・規格関連資料などを必要に応じて組み合わせて利用できます。
一方で、すべての情報を無条件にAIへ渡せばよいわけではありません。
担当業務や利用者に応じて、参照対象となる業務ナレッジを適切に制御することが重要です。
Know Narratorでは、業務ナレッジのアクセス制御機能を提供しています。
この仕組みによって、企業の情報を一つの大きな知識の塊として扱うのではなく、業務や利用者に応じて必要な情報を利用する設計が可能になります。
また、企業の最新情報が必ずしも文書に存在するとは限りません。
受注状況はERP、顧客情報はCRM、製品構成や設計情報はPLMなど、既存の業務システムに保存されていることも多いでしょう。
Know Narrator AgentSourcingには、MCPを介して外部システムと接続するコネクターエージェント機能があります。
これによって、業務ナレッジとして蓄積された知識と、外部の業務システムから取得する情報を組み合わせたAI活用を実現できます。
ここまでを整理すると、Know Narratorの役割は次のように考えられます。
| ContextOpsの観点 | Know Narratorで支えられる領域 |
|---|---|
| 業務知識の整備・活用 | 文書や業務情報を業務ナレッジとして管理し、RAGで活用 |
| 必要な情報の選択 | 複数の業務ナレッジを組み合わせて検索 |
| 情報アクセスの制御 | 業務ナレッジのアクセス制御 |
| 業務システムとの連携 | AgentSourcingのコネクターエージェントによるMCP連携 |
| 複数AIでの知識活用 | 共通の業務ナレッジを外部AIからも利用するアーキテクチャ |
Know NarratorだけでContextOpsのすべてが自動的に実現するわけではありません。
例えば、業務ルールが変更されたことを誰が検知するのか、どの情報を正とするのか、どのような評価基準でAIの回答品質を確認するのか。
こうした部分には、企業の業務に合わせた運用設計が必要です。
Know Narratorを企業の業務ナレッジ基盤として活用し、その上に情報更新、品質評価、権限管理、改善の運用を組み合わせる。
これが、私たちが考えるContextOps実現のアプローチです。
AIエージェントの運用コストにも、コンテキストの品質が影響する
ContextOpsには、もう一つ見逃せない観点があります。
それは、AIの利用コストです。
以前のコラムでは、コンテキスト長が100万トークンに拡大しても、RAGが不要になるわけではないことを、コストの観点も含めて紹介しました。
100万トークンのAI 回答精度、コスト、RAGについて考えてみた
はじめに AITCセンター長の深谷です。 最近の生成AIの進化は本当に驚かされます。GPT、Claude、GeminiなどのAIモデルは、推論能力が高くなっただけでなく、一度に読み込め…

大量の情報をAIに渡せるようになったとしても、毎回大量の文書を読み込ませることが、最も効率的とは限りません。
AIエージェントでは、複数の推論やツール呼び出しが繰り返されるため、不要な情報を何度も渡す構成は、トークン消費量や処理時間の増加につながります。
例えば、AIがある設計変更について調べる際に、社内の設計資料をすべて読み込む必要はありません。
該当する製品、設計変更の内容、適用される法規・規格などをもとに、必要な情報を選択して渡すことができれば、無駄な処理を減らせる可能性があります。
ただし、情報を絞りすぎると重要な根拠を見落とす可能性もあります。
そのため、単にトークン数を削減するのではなく、回答品質、検索漏れ、処理時間、コストを総合的に評価することが重要です。
ContextOpsは、コンテキストを正しく保つだけでなく、AIが必要な情報を効率的に利用できる状態を継続して改善することにもつながります。
ContextOpsを実現するために、企業が取り組むべきこと
では、企業がContextOpsを始めるには、何から取り組めばよいのでしょうか。私が重要だと考えるのは、次の3つです。
1.業務ナレッジの管理責任を明確にする
まず、AIが利用する業務知識を誰が管理するのかを明確にすることです。
システム部門だけでは、法規・規格の変更や、現場の業務ルールの細かな変化までは把握できません。
業務を理解している担当者が、AIに必要な情報を追加・更新できる仕組みが必要です。
以前紹介した「ナレッジエンジニア」は、この取り組みを推進する重要な役割を担います。
2.業務ナレッジとAIエージェントを分離する
次に、特定のAIモデルやAIエージェントの中に、企業固有の知識を閉じ込めないことです。
企業の業務ナレッジを共通基盤として管理し、複数のAIから利用できるようにする。
これによって、AIモデルの進化や利用ツールの変更に柔軟に対応しやすくなります。
また、業務ナレッジの更新や権限管理を共通化することで、AIエージェントごとの重複した管理も減らせます。
3.AIの回答品質とコンテキストを継続的に評価する
最後に、AIエージェントが正しく業務を実行できているかを、継続的に確認することです。
例えば、次のような観点です。
- 必要な業務ナレッジを正しく参照できているか。
- 古い情報や適用対象外の情報を利用していないか。
- 利用者の権限に合った情報を利用しているか。
- 業務システムの変更後も、正しく情報を取得できているか。
- 回答品質と処理コストが適切な水準にあるか。
問題が見つかった場合は、プロンプトやAIモデルの変更だけでなく、業務ナレッジそのものや、情報の取得方法を見直す必要があります。
こうした改善を日常的な運用として回していくことが、ContextOpsの実践につながります。
まとめ:AIモデルを育てるだけでなく、AIが使う企業の知識を運用する時代へ
生成AIの進化によって、AIエージェントができることは今後も増えていくでしょう。
しかし、どれだけ高性能なAIモデルを利用しても、古い情報や誤った業務知識をもとにしていては、企業の業務で信頼して使うことはできません。
今回紹介したContextOpsは、そうした課題に対して、AIが利用するコンテキストを継続的に管理・改善するという考え方です。
これまで私たちは、RAGを使って企業の情報をAIが読めるようにし、その回答品質を高め、さらにナレッジエンジニアによって企業の知識を育て続けることの重要性をお伝えしてきました。
ContextOpsは、そうした取り組みを、企業全体のAI活用を支える運用へと発展させる考え方だと捉えています。
これからは、ChatGPTやClaudeなどのAIモデルが進化するたびに、企業のAIシステムを一から作り直すのではなく、自社の業務ナレッジを共通の資産として持ち、さまざまなAIエージェントから安全かつ効率的に活用できる仕組みが重要になると考えています。
そして、その業務ナレッジを、業務の変化に合わせて継続的に更新・改善していく。
私たち電通総研では、Know Narratorの業務ナレッジやAgentSourcingを通じて、こうした企業のAI活用基盤づくりをご支援しています。
AIエージェントを増やすことだけを目標にするのではなく、企業の知識を、どのAIからでも正しく利用でき、継続的に育てていける仕組みを、一緒に考えていきたいと思います。
筆者
AITC センター長
深谷 勇次

