
OKF v0.2で何が変わった?――「AIが読める知識」から「AIが信頼して使える知識」へ
 fukayayuji
はじめに
AITCセンター長の深谷です。
2026年6月から7月にかけて、Open Knowledge Format(OKF)について、2本のコラムを書きました。
OKF(Open Knowledge Format)とは?AI時代の「知識コンテナ」になるか
はじめに AITCセンター長の深谷です。 生成AIやAIエージェントの活用が進むにつれて、企業の課題は「どのモデルを使うか」だけではなく、「AIにどの知識を、どの形で渡す…
 AITC | AI TRANSFORMATION CENTER

AI OKF活用入門 具体例を元にOKFを学びAI Ready Knowledge化を実現しよう
はじめに AITCセンター長の深谷です。 前回のコラムでは、Googleが2026年6月13日に提唱したOpen Knowledge Format、略してOKFについて取り上げました。 OKFは、AI時代にお…
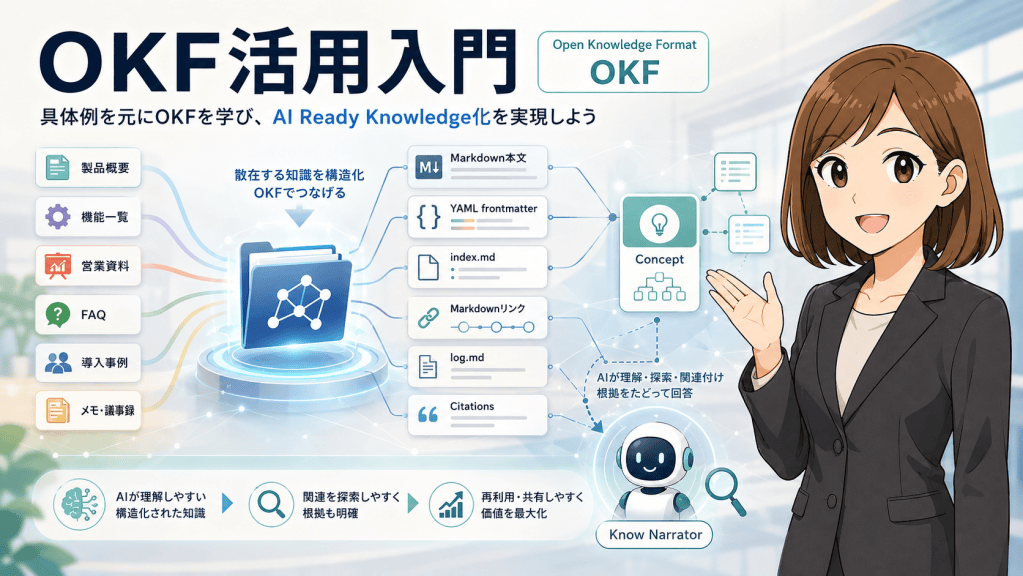
ありがたいことに、これらのOKFに関する記事は、公開後も多くの方にアクセスしていただいています。それだけ、企業のナレッジをAIが活用しやすい形にすることへの関心が高まっているのだと感じています。
そして、この数カ月の間に、OKF自体も進化しています。
当初のv0.1からv0.2へとバージョンアップされ、さらにGoogle CloudのKnowledge Catalogとの連携方法も公開されるなど、具体的な活用方法が広がってきました。
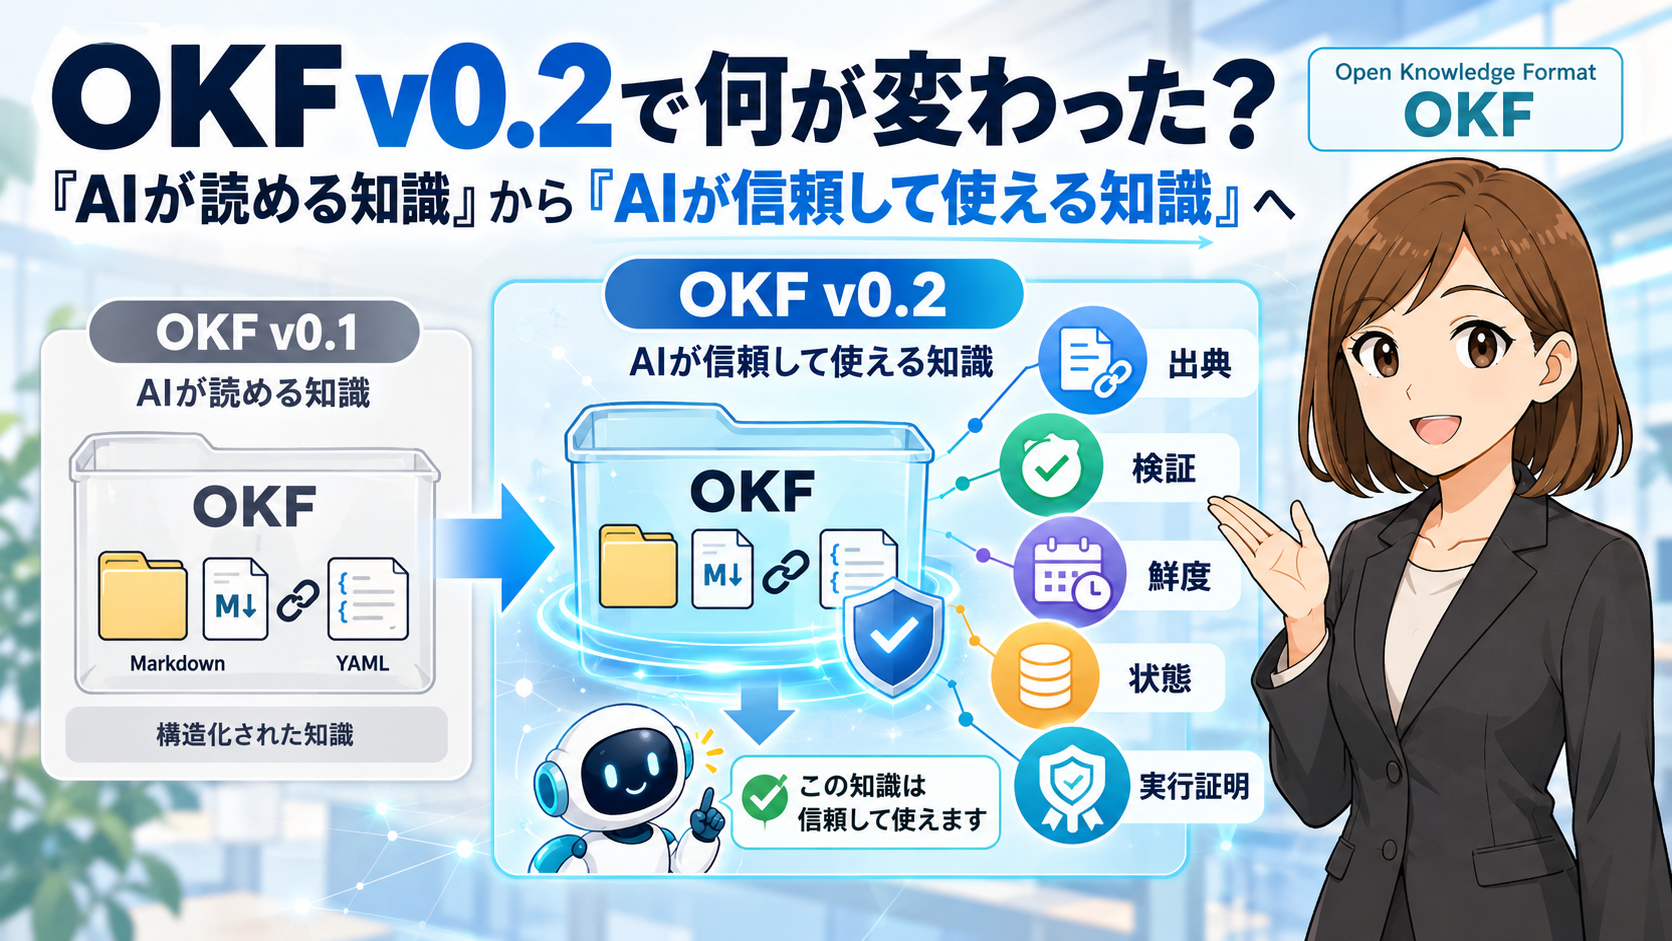
特に興味深いのは、OKFが単に「AIに知識を読ませやすくするフォーマット」から、「AIがその知識を信頼して使えるかどうかまで判断できるフォーマット」へ進化していることです。
そこで今回は、OKF v0.2で何が変わったのかを整理するとともに、以前のコラムで紹介したKnow NarratorのOKF記述例を、新しい仕様に書き換えてみたいと思います。
OKFの進化とGoogleの情報発信
まず、OKFのこれまでの動きを整理してみます。
| 日付 | 出来事 | 主な内容 | 参考資料 |
|---|---|---|---|
| 2026年6月12日 | OKF v0.1公開 | MarkdownとYAML Frontmatterを使い、AIエージェントと人間が共通して利用できる知識記述形式を公開。 | Google Cloud公式ブログ |
| 2026年7月24日 | OKF v0.2公開 | 出典(Provenance)、検証(Verification)、鮮度(Freshness)、ライフサイクル(Lifecycle)、計算結果の検証(Attestation)に関する仕様を拡張。 | Google Cloud公式ブログ |
| 2026年8月21日 | v0.2仕様修正 | 日時フィールドをISO 8601形式に統一し、UTCオフセットの明示に関する規定を整理。 | GitHub公式仕様(最新版) |
| 2026年8月26日 | Knowledge Catalog連携の紹介 | Google CloudのKnowledge Catalogとの連携により、OKFの知識を組織横断で検索・管理・共有し、AIエージェントが活用する方法を紹介。 | Google Cloud公式ブログ |
v0.1が公開されたのは6月12日。そしてv0.2が公開されたのは7月24日です。
わずか42日間で、大きな機能拡張が行われたことになります。
ちなみに、以前のコラムで紹介したGitHubのディレクトリは、現在では保守を終了したスナップショットになっています。
今後は、独立した以下のリポジトリを参照するのがよいでしょう。
GitHub - GoogleCloudPlatform/open-knowledge-format · GitHub
Contribute to GoogleCloudPlatform/open-knowledge-format development by creating an account on GitHub.
v0.2の最大の変更点は「知識の信頼性」を扱えるようになったこと
以前のコラムでは、OKFを「AI時代の知識コンテナ」として紹介しました。
企業の中にある製品情報、提案書、FAQ、設計情報、業務マニュアルなどを、MarkdownとYAMLで整理し、関連する知識をリンクでつなぐ。これによって、AIが目的に応じて必要な知識を探索し、組み合わせて利用しやすくなります。この基本的な考え方はv0.2でも変わっていません。
では、何が変わったのでしょうか。
v0.1では主に、「これは何についての知識なのか」「どこに関連情報があるのか」を扱っていました。
一方、v0.2では、さらに次のようなことを扱う定義が追加されました。
| 観点 | AIが確認したいこと | v0.2の主な項目 |
|---|---|---|
| 出典(Provenance) | この情報は何を根拠に作られたのか? | sources |
| 信頼性(Trust) | 誰が作成し、誰が確認したのか? | generated, verified |
| 鮮度(Freshness) | この情報は今でも有効なのか? | stale_after |
| ライフサイクル(Lifecycle) | この情報は正式版か、廃止済みか? | status |
| 実行証明(Attestation) | この数値は定められた計算方法で算出されたのか? | Attested Computation |
例えば、AIがある製品の仕様について答えようとしたとします。
該当する製品情報が見つかったとしても、それが3年前の古い資料だったらどうでしょうか。
あるいは、AIが自動生成した製品説明で、人間が一度も内容を確認していなかったらどうでしょうか。
AIは文章として回答できるかもしれません。しかし、その回答を営業提案や設計業務にそのまま使ってよいのかは、別の問題です。
「知識を見つけられること」と「その知識を安心して業務に利用できること」は、同じではありません。
v0.2は、この違いを意識した仕様になっています。これらの追加項目は基本的に任意です。必須項目がtypeだけという、OKFのシンプルな設計思想は維持されています。
以前のKnow NarratorのOKFをv0.2で書き直してみる
それでは、具体例を見ていきましょう。
以前のコラムでは、Know Narratorの製品情報を、営業提案やナレッジ再利用を目的としたOKF形式に変換しました。
AI OKF活用入門 具体例を元にOKFを学びAI Ready Knowledge化を実現しよう
はじめに AITCセンター長の深谷です。 前回のコラムでは、Googleが2026年6月13日に提唱したOpen Knowledge Format、略してOKFについて取り上げました。 OKFは、AI時代にお…
その中のproduct/overview.mdというファイルを例にします。
まず、以前のv0.1の記述
当時は、次のような内容を紹介しました。
type: "Product Overview"title: "Know Narrator 製品概要"description: "Know Narratorは、組織に散在する知を高精度AIで結集・活用する生成AIプラットフォーム。"resource: "https://aitc.dentsusoken.com/products/knownarrator/"tags: ["Know Narrator", "営業ナレッジ", "提案書作成", "生成AI", "製品概要", "組織のAI基盤"]timestamp: "2026-07-06T13:00:00+09:00"# SummaryKnow Narrator(ノウナレーター)は、電通総研が提供する生成AIプラットフォームです。# Key Facts| 項目 | 内容 ||---|---|| 製品名 | Know Narrator || 提供価値 | 組織に散在する知の結集・活用 || 導入実績 | 130社以上 || 導入後継続率 | 91%以上(2026年3月時点) |<中略># Related Concepts* [特徴・機能](/product/features.md)* [3つの強み](/product/strengths.md)* [提案プレイブック](/sales/proposal-playbook.md)* [営業トークトラック](/sales/talk-track.md)# Citations[1] [情報元ページ: Know Narrator](https://aitc.dentsusoken.com/products/knownarrator/)[2] 情報元ファイル 電通総研の生成AI活用プラットフォーム: Know Narrator.html
この形式でも、AIは製品概要を理解し、関連する知識を参照できます。
ただし、情報の出典はMarkdown本文の最後に記述され、作成履歴もtimestampだけです。
この知識を誰が作成したのか、内容が検証済みなのか、現在でも有効なのかといった情報までは、標準化されていませんでした。
v0.2ではこのように変わります
同じKnow Narratorの製品概要を、v0.2の仕様で記述すると、次のようになります。
---
type: "Product Overview"
title: "Know Narrator 製品概要"
description: "Know Narratorは、組織に散在する知を高精度AIで結集・活用する生成AIプラットフォーム。"

resource: "https://aitc.dentsusoken.com/products/knownarrator/"

tags:
  - "Know Narrator"
  - "営業ナレッジ"
  - "提案書作成"
  - "生成AI"
  - "製品概要"
  - "組織のAI基盤"

generated:
  by: "human:USER-ID"
  at: "2026-07-06T13:00:00+09:00"

status: stable

sources:
  - id: know-narrator-web
    resource: "https://aitc.dentsusoken.com/products/knownarrator/"
    title: "Know Narrator 製品紹介ページ"

  - id: know-narrator-source
    resource: "sources/extracted-text.md"
    title: "Know Narrator 製品情報の抽出テキスト"
---

# Summary

Know Narrator(ノウナレーター)は、
電通総研が提供する生成AIプラットフォームです。[^know-narrator-web]

# Key Facts

| 項目 | 内容 |
|---|---|
| 製品名 | Know Narrator |
| 読み | ノウナレーター |
| 提供価値 | 組織に散在する知の結集・活用 |
| 導入実績 | 130社以上(元記事掲載時の情報) |
| 導入後継続率 | 91%以上(2026年3月時点) |

<中略>

# Related Concepts

* [特徴・機能](/product/features.md)
* [3つの強み](/product/strengths.md)
* [提案プレイブック](/sales/proposal-playbook.md)
* [営業トークトラック](/sales/talk-track.md)

[^know-narrator-web]: Know Narrator 製品紹介ページ※上記は書式を説明するための例です。USER-IDは仮の作成者IDです。元記事のtimestampをgenerated.atに引き継ぐ場合は、その日時が実際に内容を作成・更新した日時であることを確認する必要があります。導入実績や継続率も、元記事当時の情報として掲載しています。
一見すると、それほど大きく変わっていないように思えるかもしれません。
しかし、いくつか重要な違いがあります。
変更点1:timestampからgeneratedへ
以前のtimestampは、次のような形式でした。
timestamp: "2026-07-06T13:00:00+09:00"
v0.2では、次のように作成主体と日時をまとめて管理できます。
generated: by: "human:USER-ID" at: "2026-07-06T13:00:00+09:00"
これによって、単に「いつ更新されたか」だけでなく、「誰が作成・更新したのか」も記録できます。
byには、人間であればhuman:担当者ID、自動処理ならprocess:処理ID、AIエージェントならエージェント名/バージョンといった識別子を記述します。
AIエージェントが大量の知識を自動生成するようになったとき、作成主体を追跡できることは重要です。
変更点2:# Citationsからsourcesへ
もう一つの大きな変更が、出典情報の扱いです。
以前は、Markdown本文の最後に# Citationsという見出しを作り、その下に出典を並べていました。
v0.2では、出典をYAML frontmatterのsourcesに構造化して記述します。
sources: - id: know-narrator-web resource: "https://aitc.dentsusoken.com/products/knownarrator/" title: "Know Narrator 製品紹介ページ"
さらに、本文中ではMarkdownの脚注を利用して、どの記述がどの出典に基づいているのかを示せます。
ここで重要なのがidです。
本文に記載された[^know-narrator-web]と、sourcesのidを対応させることで、AIやプログラムが出典を機械的に追跡できるようになります。
また、必要に応じて、出典の作成者や最終更新日時、利用回数といった情報も持たせることができます。
つまり、出典を単に文章として残すのではなく、AIが参照・検証できる構造化された情報として管理できるようになったわけです。
変更点3:検証履歴をverifiedで管理できる
さらに、今回の例には記載していませんが、v0.2ではverifiedという項目が追加されています。
例えば、製品担当者が内容を確認した場合には、次のように記述できます。
verified: - by: "human:REVIEWER-ID" at: "2026-10-12T15:00:00+09:00"
※これは記述方法を示す架空の例です。実際に検証が完了した場合に、その実績として記録します。
verifiedがない場合は未検証として扱い、人間が確認した場合と、自動処理だけで確認した場合を区別できます。
例えば、営業AIエージェントが提案書を作成する場面を考えてみましょう。
製品の機能説明であれば、AIが自動生成した未検証の情報も、ドラフト作成には利用できるかもしれません。
しかし、顧客に正式に提示する機能保証やセキュリティ要件の説明であれば、製品責任者が確認した情報だけを利用する、といった運用が考えられます。
なお、verifiedがあること自体が情報の正確性を保証するわけではありません。どの資料に対して、何を確認したのかという検証プロセスそのものも大切です。
変更点4:知識の有効期限をstale_afterで管理できる
企業のナレッジには、時間がたつと古くなるものが数多くあります。
例えば、製品の価格、サポート対象、セキュリティ認証情報、適用可能な設計標準などです。
v0.2では、そのような知識にstale_afterを設定できます。
stale_after: "2027-01-01T00:00:00+09:00"
これは、日本時間の2027年1月1日0時以降、その知識を古いものとして判定するための設定です。
AIエージェントは、指定時刻を過ぎた情報について、再確認を促したり、回答への利用を制限したりすることができます。
もちろん、すべての知識に有効期限が必要なわけではありません。更新頻度が高い知識や、古い情報を使うことの影響が大きい知識から設定すればよいと思います。
2026年8月の追加修正:日時の書き方も統一された
v0.2の公開後、2026年8月21日には、日時の表記方法についても仕様が明確化されました。
具体的には、日時を表す項目はISO 8601形式で記述し、UTCオフセットを明示するルールです。例えば、次のような表記です。
| 表記例 | v0.2での扱い |
|---|---|
2026-06-30 | NG:日付しかない |
2026-06-30T14:00:00 | NG:タイムゾーンが不明 |
2026-06-30T14:00:00Z | OK:UTCの14時 |
2026-06-30T14:00:00+09:00 | OK:日本時間の14時 |
日本時間で書く場合は、末尾に+09:00を付ければよいわけです。
これは一見すると細かい修正ですが、グローバルに分散したシステムやAIエージェントが、同じ知識を利用する場面では重要です。
例えば、stale_afterによる有効期限の判定を、日本のシステムと米国のシステムで違う解釈にしてしまうことを防げます。
さらに注目したい「Attested Computation」とは?
v0.2では、もう一つ興味深い機能が追加されています。それがAttested Computationです。
これは、AIが扱う数値について、「どのように計算すべきか」という定義だけでなく、「実際にその計算方法で算出されたのか」を確認するための仕組みです。
例えば、営業部門のAIエージェントに次のような質問をしたとします。
「今年度の売上はいくらですか?」
AIはデータベースを検索して売上を集計できます。
しかし、ここには問題があります。
その企業では、売上の定義として、キャンセル分を除外する、検収済みの案件だけを対象にする、計上日を基準にするなど、独自のルールがあるかもしれません。
もしAIが独自のSQLを生成して集計してしまうと、見た目は正しい数値でも、企業が定義した正式な売上とは異なる可能性があります。
v0.2では、このような計算処理を独立したConceptとして管理できます。例えば次のような構成です。
---
type: "Attested Computation"
title: "年度別売上集計"

parameters:
  - name: year
    type: integer
    required: true

executor:
  resource: "references/skills/run-sales-query.md"
  receipt:
    - job_id
    - executed_sql
    - result

attester:
  resource: "references/attesters/check-sales-query.py"
---

# Computation

SELECT SUM(sales_amount) AS total_sales
FROM sales.approved_sales
WHERE fiscal_year = @year
※SQLや参照ファイルは仕組みを説明するためのサンプルです。実際の企業の売上定義を表しているものではありません。
ここでは、executorが定義された処理を実行し、その実行結果やSQLをreceiptとして返します。
そしてattesterが、その実行結果を検証します。
ポイントは、AIが自分で考えたSQLを実行したのではなく、企業が定めた計算方法に従って処理されたことを確認できる点です。
ただし、OKF自体がSQLを実行したり、結果を自動検証したりするわけではありません。実行機能や検証プログラムは、別途実装する必要があります。
ここまで来ると、OKFは単なる文章の整理方法ではなく、業務ルールや計算方法をAIと共有するための仕組みにもなってきたと感じます。
OKFの活用は、知識コンテナから企業全体のナレッジ基盤へ
さて、ここまでv0.2の変更点を見てきましたが、もう一つ注目していることがあります。
それは、OKFの活用方法そのものが広がってきていることです。
Google Cloudが公開しているOKFのリポジトリには、GA4のECデータ、Stack Overflowの公開データ、Bitcoinのトランザクションデータ、架空の小売企業Acme Retailなど、さまざまなサンプルバンドルが用意されています。
これらは実装例・検証用のサンプルであり、すべてが実企業の本番導入事例というわけではありません。しかし、OKFが単なる文書管理だけでなく、データ定義や業務ルール、分析処理にまで応用できることを示しています。
さらに2026年8月26日には、Google Cloudが、OKFをKnowledge Catalogと連携させる方法を公式ブログで紹介しました。これも重要な動きです。
OKFは、もともとMarkdownファイルの集合として設計されています。そのため、ファイルをGitで管理することは簡単ですが、企業全体で利用しようとすると、検索、アクセス権限、更新管理、既存業務システムとの連携などを考える必要があります。Knowledge Catalogとの連携では、OKFのConceptをカタログのエントリとして管理し、既存の検索機能やアクセス権限制御を活用する構成が紹介されています。つまり、個別に作成した知識コンテナを、組織横断で利用する方向へ発展させようとしているわけです。
ただし、OKFそのものはベンダーニュートラルな仕様です。Google CloudのKnowledge Catalogを使うことが必須というわけではありません。
私は、この方向性は企業のAI活用にとって重要だと考えています。なぜなら、企業の知識は、一つのシステム、一つの部署、一つのファイルにまとまっているわけではないからです。設計情報はPLMに、品質情報は品質管理システムに、営業情報はCRMに、日々の判断や会議の記録はTeamsやSharePointに存在するかもしれません。こうした複数の知識を、AIが適切に探索し、信頼性を確認しながら利用できるようにする。そのためには、知識の表現形式だけでなく、検索基盤、権限制御、業務システム連携を組み合わせて考える必要があります。
企業がOKFを活用するなら、「誰が知識を更新するのか」まで考える
ここで、もう一つ考えておきたいことがあります。
v0.2によって、知識の出典、作成者、検証履歴、鮮度などを記録しやすくなりました。しかし、OKFを導入するだけで企業の知識が自動的に増えたり、正しく更新されたりするわけではありません。
例えば、ある設計者がAIに、部品の材料変更による影響について質問したとします。AIが既存の設計標準や過去の不具合情報を調べた結果、「材料変更時には疲労強度の再評価が必要」ということが分かったとします。ところが、その判断の根拠になった設計ルールが、まだ企業のナレッジとして整理されていなかったらどうでしょうか。
そのとき重要なのは、AIとの対話をそのまま保存することではありません。
担当者が「この設計ルールは今後も必要な知識だ」と判断し、根拠となる情報を追加し、必要であれば検証したうえで、組織の知識として登録することです。
その際、OKF v0.2のsourcesやverified、generatedなどの情報が役立ちます。
誰が追加し、何を根拠とし、いつ確認したのか。そうした情報を知識と一緒に残すことで、次にAIを使う担当者は、前回よりも確かな情報を参照できるようになります。
以前のコラムでも紹介しましたが、企業の知識を増やしていくには、業務を担当する人が日常的に知識を追加・改善できる仕組みが必要だと思っています。そして、こうした知識の整備・維持を支える役割として、ナレッジエンジニアの重要性も高まっていくでしょう。
Know Narratorと組み合わせて考える企業のAI Ready Knowledge
電通総研では、生成AI活用プラットフォーム「Know Narrator」を通じて、企業内のさまざまなナレッジをAIが活用できる仕組みを提供しています。
特にKnow Narrator Searchでは、企業内の複数の業務ナレッジを横断して検索し、必要な情報を組み合わせて回答することを重視しています。また、Know Narrator AgentSourcingでは、業務システムと接続するコネクターエージェントなどを通じて、AIの活用範囲を広げることができます。
こうした仕組みと、OKFのような知識を構造化する考え方を組み合わせることには、大きな可能性があると感じています。
ただし、OKFの形式を採用することと、実際に企業のRAGやAIエージェントから活用できることは別です。OKFのファイルをどのように登録・検索するのか。sourcesやverifiedなどのメタデータを、回答生成時の判断にどう反映するのか。権限をどのように制御するのか。こうした仕組みを含めて設計することが重要です。
例えば将来的には、次のようなAI活用が考えられます。
- 「この製品の最新の仕様を教えて。ただし、製品担当者が検証済みの情報を優先して」
- 「この設計変更に適用すべき社内標準を教えて。廃止済みの標準は除外して」
- 「今年度の売上を教えて。正式に承認された集計ルールで計算して」
単に文書を検索して回答するだけではなく、企業が認めた知識を、適切な条件で利用するAIです。
これこそが、企業のAI Ready Knowledgeを考えるうえで、今後ますます重要になってくるのではないでしょうか。
まとめ
今回、OKF v0.2の変更点と、Know Narratorの製品情報を使った記述例を紹介しました。
v0.1では、企業の知識をMarkdownとYAMLによって、AIが探索・利用しやすい形に整理することが中心でした。
v0.2では、それに加えて、知識の出典、作成者、検証履歴、有効期限、計算方法などを管理できるようになっています。
この変化は、企業の生成AI活用において非常に重要だと思っています。
生成AIの性能が向上し、AIエージェントがさまざまな業務を担うようになるほど、その判断の根拠となる企業の知識の重要性は高まります。そして、その知識は一度整備すれば終わりではありません。業務の中で新しく分かったことを担当者が追加し、古くなった情報を更新し、必要な内容を確認していく。そうした活動を通じて、企業の知識は少しずつ増え、活用できるものになっていきます。
AIが読める知識を作ること。そして、その知識を信頼して使える状態に育て続けること。
OKF v0.2は、その後者について考えるための重要な進化だと感じています。
我々電通総研では、Know Narratorをはじめとする生成AI活用基盤の構築だけでなく、企業内に散在する知識をどのように整理し、AIに活用させ、継続的に改善していくかという仕組みづくりも支援しています。
- AIを導入したけれど、社内のナレッジを十分に活用できていない
- AIエージェントに業務を任せたいが、判断の根拠となる知識が整備されていない
- 企業の知識を、組織横断でAI活用できるようにしたい
そのような課題をお持ちの方は、ぜひ電通総研にご相談ください。
筆者
AITC センター長
深谷 勇次
