そのRAG、本当に正しく答えていますか?~Excel・PowerPoint・PDFを読み取った、その先にある「回答品質」の壁~
 fukayayuji

はじめに
AITCセンター長の深谷です。
前回、前々回のコラムでは、企業に蓄積されたExcelをRAGで活用する方法や、PowerPoint・PDFに含まれる画像、グラフ、表まで理解する「マルチモーダルRAG」について紹介してきました。

従来のRAGでは、文書に書かれた文字情報は検索できても、複雑な表やグラフ、図面などに含まれる情報を十分に活用できないという課題がありました。
しかし、AIのマルチモーダル能力を上手く活用することによって、こうした情報も扱えるようになってきています。
では、ExcelもPowerPointもPDFも、AIがしっかり読み取れるようになれば、企業のRAG活用は成功するのでしょうか?
実は、そう簡単ではありません。
「資料を読み取れること」と「業務で正しく答えられること」は、まったく別の話だからです。
例えば、過去の設計トラブルをAIに質問したところ、類似した不具合と対策を回答してくれたとします。一見すると、素晴らしい回答に見えましたが、よく確認すると、その対策は特定の温度条件でしか有効ではなかった。AIは肝心の適用条件を見落としていたのです。
これでは、必要な資料を見つけられていても、業務で安心して利用することはできません。
さらに、企業の業務では、必要な情報が一つの資料にまとまっているとは限りません。複数部門の資料を横断し、場合によっては業務システムに接続して最新の情報を取得する必要もあります。
そして、その情報を誰が利用してよいのかという権限管理も欠かせません。
今回は、RAGの回答品質をどう考え、どのように改善していけばよいのか。そして、企業に蓄積された知識とAIエージェントを組み合わせ、どのような業務活用を実現していくのかについてお話しします。
書いているうちに、伝えたいことが次々と出てきて、いつの間にか少し長めの記事になってしまいました。ただ、それだけ今回のテーマには、これからの企業AIを考えるうえで大切な論点が詰まっています。少し長いですが、ぜひお時間のあるときに、ゆっくりお読みいただければと思います。
RAGの回答品質は、どこで決まるのか?
まず、RAGが回答を生成するまでの流れを整理してみましょう。
RAGは、大きく次のような4つのステップで動いています。
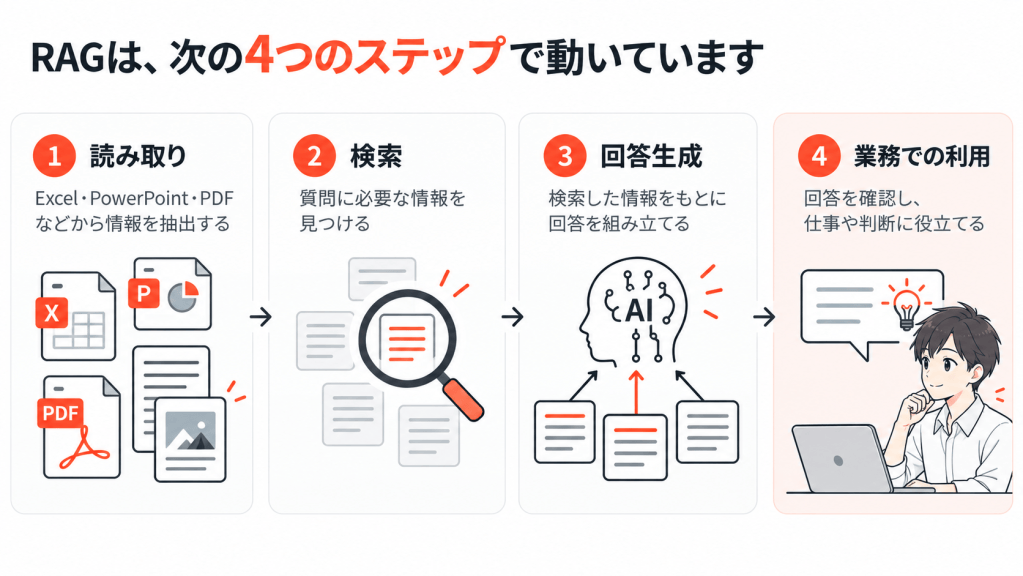
例えば、設計部門で過去の不具合を検索するケースを考えてみます。
質問は「低温環境で発生した部品Aの不具合と、その対策を教えてください」にします。以下、それぞれのステップで起こりうる問題を挙げてみます。
| 段階 | 起こり得る問題 |
|---|---|
| 読み取り | Excelの右端にある適用条件を取り込めていない |
| 検索 | 部品Aではなく、類似する部品Bの事例を参照してしまう |
| 回答生成 | 対策自体は正しいが、必要な適用条件を省略してしまう |
| 業務での利用 | 担当者が適用条件を確認せず、その対策を採用してしまう |
どの段階で問題が起きても、最終的な業務品質に影響します。
しかも、最も厄介なのは、間違っている回答でも自然な日本語で、もっともらしく説明されてしまうことです。
だからこそ、RAGの回答品質を改善するには、AIモデルだけを見るのではなく、読み取りから業務利用までを一連の仕組みとして考える必要があるわけです。
まずは「正しい回答とは何か」を決める
では、RAGの品質をどのように評価すればよいのでしょうか?
最初に取り組むべきなのは、業務で使う質問と、その質問に対する期待する回答を用意するから始めるべきです。
例えば、過去トラブルの活用をテーマにしたとしましょう。その場合、次のような質問と、期待する回答を用意します。
質問:「部品Aで低温環境下に発生した不具合の原因と対策を教えて」
期待する回答:
- 発生現象:低温環境で樹脂部品に亀裂が発生
- 原因:材料の低温脆化と応力集中
- 対策:材料変更と形状の見直し
- 適用条件:対象材料・温度範囲・設計変更後の検証条件
- 根拠:該当する不具合管理票と設計検証資料
ここで重要なのは、単に「原因と対策が合っているか」だけではないことです。
適用条件を説明できているか。根拠となった資料を確認できるか。資料に書かれていないことまで、勝手に推測していないか。こうした業務上の観点まで含めて、期待回答を定義します。
そして、実際のRAGの回答と比較します。
例えば、原因と対策は正しかったものの、適用条件が抜けていた場合は、単純に正解とせず、何が不足していたかを記録するわけです。
これを繰り返すことで、「なんとなく精度が悪い」という議論から、「どの質問で、どの情報が不足しているのか」という具体的な改善につなげることができます。
なお、こうした評価では、LLMによる自動評価も活用できます(※)が、業務上の正解や重要な判断基準は、実際の業務を理解している人が確認することが大切です。
(※)Know Narrator AgentSourcingのAIエージェントアプリの中には、"エージェントオプティマイザー"があります。この"エージェントオプティマイザー"は、エージェントの回答品質やツール利用を評価・分析し、改善案やシステムプロンプトの修正案を提示することで、継続的な品質向上を支援することができます。

RAGの品質は、正答率だけで評価してはいけない
正答率は分かりやすい指標ですが、企業でのRAG活用では、それだけでは不十分です。重視するのは、次の6つの観点です。
| 評価観点 | 確認すべきこと |
|---|---|
| ① 情報の網羅性 | 必要な情報が漏れずに含まれているか |
| ② 根拠との整合性 | 参照資料に基づいた回答になっているか |
| ③ 条件・例外の正確性 | 適用条件や例外を正しく扱えているか |
| ④ 情報の鮮度 | 古い情報を最新のものとして扱っていないか |
| ⑤ 回答不能時の振る舞い | 根拠がない場合に、無理に回答を作らないか |
| ⑥ 情報の権限制御 | 利用者が参照してよい情報だけを使っているか |
企業では、質問に対して必ず回答を返すことが、必ずしも正解とは限りません。必要な情報が見つからなかったのであれば、「該当する情報を確認できませんでした」と回答する方が適切な場合があります。
また、よくある話しですが、旧版と新版の規程が見つかった場合、どちらが適用されるのかを確認できていないにもかかわらず、片方を選んで断定してしまうことも避けるべきです。
そして、⑥の権限制御も忘れてはいけません。
例えば、人事部門の担当者と一般社員が、同じ人事関連の質問をしたとします。
人事部門の担当者には詳細な情報へのアクセス権があっても、一般社員には公開されていない情報があるかもしれません。その場合、利用者に応じて参照できる情報を適切に制御する必要があります。これは、単なる検索精度の問題ではなく、企業の情報セキュリティに関わる問題です。
業務で使えるAIとは、何でも答えるAIではなく、適切な情報を参照し、根拠に基づいて答え、答えられないことを適切に扱えるAIです。そして、これらの評価項目は、業務によって重要度が変わります。
社内の一般的な問い合わせと、製品の安全性に関わる設計判断では、求められる品質や人による確認の必要性が異なるからです。
品質改善は、一度実施すれば終わりではない
評価によって問題が見つかったら、次は原因を切り分けて改善します。
例えば、Excelの右端に記載された適用条件が回答に含まれていなかったとしましょう。
この場合、まず元のExcelから情報が正しく抽出されているかを確認します。抽出されていなければ、文書の読み取り方法を改善する必要があります。抽出されているのに検索されなければ、検索方法や情報の分割方法を見直します。検索結果には含まれているのに回答から漏れているのであれば、回答生成の指示やモデルの処理を見直す必要があります。
このように、問題が起きた場所によって、改善すべき技術は異なります。
Know NarratorのマルチモーダルRAGには、Excelのセル情報をPDFに変換せず直接抽出するオプションがあります。また、文書のページ全体やページ内の画像・図表からキャプションを生成し、重要なオブジェクトについては注目する情報や抽出方法を設定できます。
また、社内の情報は日々更新されます。
設計標準が改訂され、新たな不具合事例が追加され、業務規程も変更されます。導入時に正しく答えられていても、その状態がずっと続くとは限りません。
そのため、実際の利用状況を把握しながら、継続的に品質を改善する仕組みも重要になります。
Know Narratorでは、利用履歴を分析する「Know Narrator Insight」を提供しています。ユーザーの質問やAIの回答品質を分析し、期待する回答が得られていないケースを把握することで、プロンプトや参照文書の改善につなげられます。
もちろん、分析結果から何を改善するかについては、技術的な判断だけでなく、業務担当者の知識も必要です。
我々AITCでは、RAGの精度を評価する仕組みと、実際の業務に合わせた改善の両方を重視しています。
さらに難しいのは、企業の正解が一つの資料やシステムに存在するとは限らないこと
ここまでは、資料に含まれる情報を正しく読み取り、回答することを中心に説明してきました。
しかし、実際の企業業務は、さらに複雑です。
例えば、設計部門の担当者が、次のような質問をしたとします。
「部品Aの材料を変更したいのですが、過去の不具合を踏まえて、どのような検証が必要ですか?」
この質問に回答するための情報は、一般的には、一つのファイルにまとまっていることはありません。
過去の不具合情報は品質部門のExcelに、材料特性は技術資料のPDFに、評価結果はPowerPointに記録されているかもしれません。さらに、現在採用している部品の情報はPLMや部品管理システムに登録されている可能性があります。
つまり、必要な情報が社内のさまざまな場所に分散しているわけです。
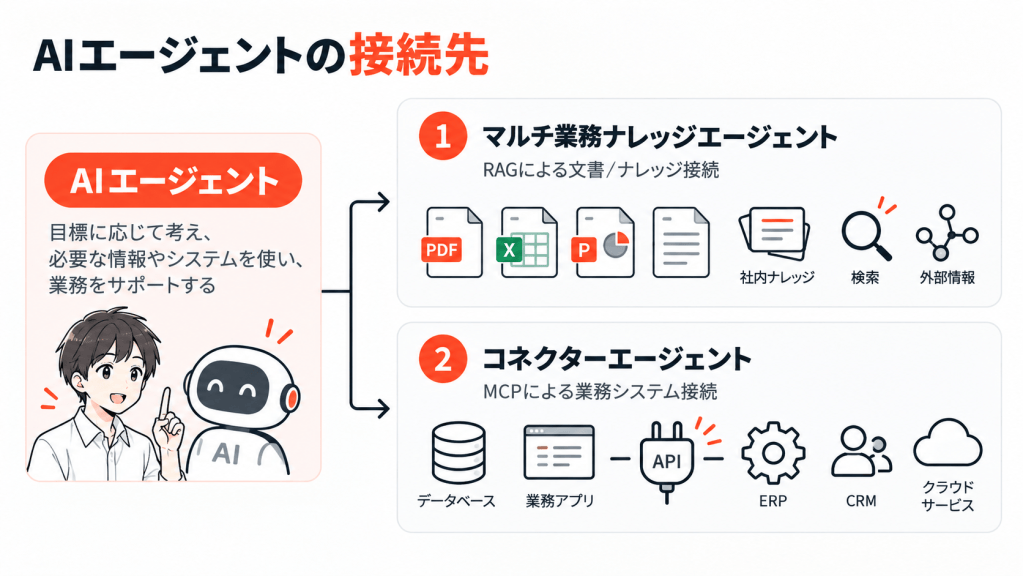
この問題を解決するには、二つの技術的なアプローチが重要になります。
① 複数の業務ナレッジを横断して活用する
1つ目は、複数の業務ナレッジを横断的に参照することです。
例えば、設計標準、過去トラブル一覧、技術資料、暗黙知となりうるミーティング情報を、それぞれ独立した業務ナレッジとして管理します。
AIエージェントは、質問の内容に応じて必要な業務ナレッジを選択し、情報を取得します。
今回の材料変更の質問であれば、過去の不具合から変更時の注意点を確認し、設計標準から必要な検証項目を調べ、技術資料から材料特性を確認する、といった流れです。
一つの資料では答えられなかった質問に対して、複数の情報を組み合わせた回答を生成できるようになります。
② MCPを使って、自社の業務システムの情報を取得する
2つ目は、社内文書だけでなく、業務システムに接続することです。
ここで重要になるのが、MCP(Model Context Protocol)です。
MCPは、AIエージェントが外部のサービスやシステムと接続し、情報取得や操作を行うための標準的な仕組みです。
例えば、先ほどの材料変更の質問に対して、PLMから現在の部品構成や設計変更履歴を取得したり、要求管理システムから要求情報を確認したりすることが考えられます。
これらは、文書をRAGに登録しておくだけでは実現しにくい情報活用です。
特に、データベースで管理されているような、日々変化する情報などは、必要なときに業務システムから最新の情報を取得することが必要です。
Know Narratorでは、このようなMCPによる接続を実現するために、AgentSourcingの「コネクターエージェント」を提供しています。
コネクターエージェントは、Know Narratorに登録したMCPサーバーを対話画面から利用できる機能です。外部サービスからの情報取得や、ファイル操作などに対応しています。接続先にMCPサーバーが提供されていない場合でも、業務システムのAPIなどを利用してMCPサーバーを個別開発することで、連携を実現するアプローチが考えられます。
実際に接続する際には、対象システムのAPI仕様、認証方式、操作権限などに応じた設計が必要です。現行機能の組み合わせや個別のシステム連携を含め、お客様の業務に適した構成を設計していくことが重要です。
企業の業務で本当に役立つAIを実現するには、文書に記録された知識だけでなく、業務システムに蓄積されたデータも活用することが重要です。
「RAGで企業の知識を理解する」ことと、「MCPで業務システムにつながる」こと。この二つを組み合わせることで、AIエージェントの活用範囲はさらに広がります。
Know Narratorの強みは「マルチ業務ナレッジ」にある
Know Narratorには様々な特徴がありますが、Know Narratorの大きな強み、そして今後ますます重要になる価値は、「マルチ業務ナレッジ」にあると考えています。
Know Narratorでは、企業固有の文書やナレッジを業務ナレッジとして管理できます。
また、AgentSourcingの「マルチ業務ナレッジエージェント」では、質問に応じて複数の業務ナレッジを自動的に選択・横断検索し、取得した情報を統合した回答を生成できます。
ここで重要なのは、単に複数の業務ナレッジを検索できることだけではありません。必要に応じて横断検索できる一方で、業務や利用者に応じて検索対象を適切に絞り込めることも、非常に重要です。
検索対象を増やせば、必ず精度が上がるわけではない
例えば、社内のすべての文書を一つの巨大な検索対象に登録したとしましょう。
設計部門の担当者が「材料変更時の検証項目」を質問した際に、営業資料や古い製品の設計資料、別事業部の技術標準などが検索されるかもしれません。そうして検索対象が広がるほど、似ているものの適用対象が異なる情報や、今回の質問には不要な情報が混在する可能性があります。
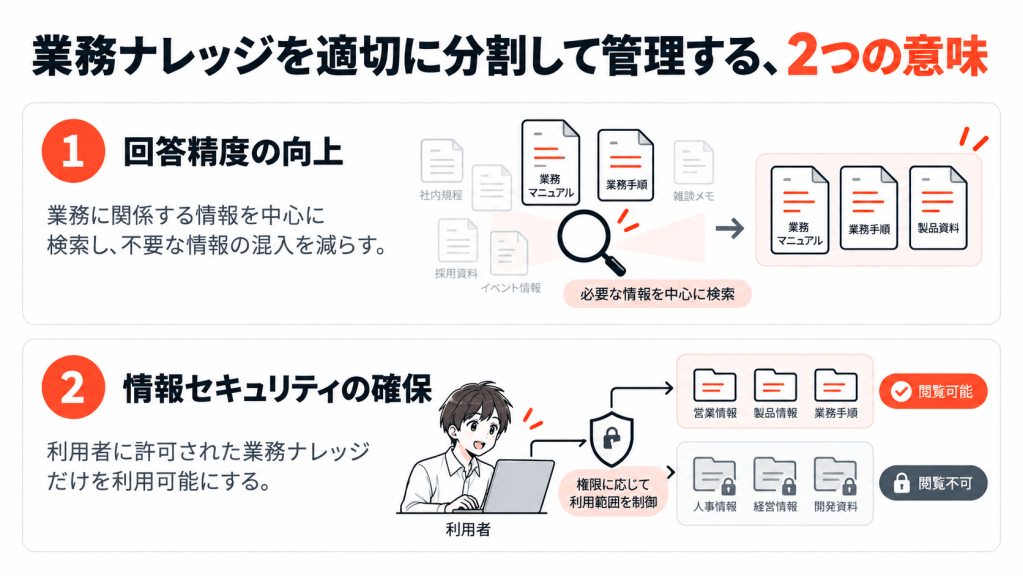
そこで、業務ナレッジを部門や用途などの単位で分けて管理します。
例えば、設計部門の質問であれば、設計標準、技術資料、過去トラブルなどを中心に検索する。人事部門の質問であれば、人事規程や労務関連資料を中心に検索する。
このように、質問の意図に応じて検索対象を絞ることで、関係のない情報が回答に混入するリスクを減らせます。
Know Narratorのマルチ業務ナレッジエージェントは、質問の意図を解析し、適切なデータソースを自動選択する仕組みを備えています。
必要なときには複数の業務ナレッジを横断し、不要なものは検索対象から外す。
このような、AIに渡される情報の足し算/引き算が、回答品質の向上につながります。
利用者ごとの権限制御も重要
そして、もう一つ重要なのが、情報の権限制御です。
企業では、部門や役職によって参照できる情報が異なります。人事情報、経営情報、顧客との契約情報など、利用者に応じてアクセスを制限しなければならない情報が多数存在します。
Know Narratorでは、業務ナレッジごとにユーザーやグループのアクセス権限を設定できます。
例えば、人事部門だけが利用できる業務ナレッジを用意した場合、権限を持たない一般社員がその業務ナレッジを利用することはできません。あらかじめ業務ナレッジに権限を設定しておけば、利用者に応じたアクセス制御をシステム側で適用できます。
つまり、業務ナレッジを適切に分割して管理することには、二つの意味があります。
なお、MCP経由で別の業務システムに接続する場合は、その接続先でも認証や権限の確認が必要です。
このように、情報を「どれだけ多く検索できるか」だけではなく、「誰に、どの情報を、どのような条件で検索させるか」まで設計することが重要です。
マルチモーダルRAGで資料の中まで読み取り、マルチ業務ナレッジで必要な情報を適切に選択し、権限制御によって安全に活用する。これらを組み合わせることが、企業のRAGを実際の業務で活用するための重要なポイントです。
フロントはChatGPT WorkやClaude Coworkでもよい。Know Narratorを企業のナレッジ基盤に
そして、もう一つお伝えしたいことがあります。企業のAI活用を考えるとき、すべてを一つのAIエージェントで完結させる必要はありません。
ChatGPT Workは、情報の調査・分析に加えて、文書やスプレッドシート、プレゼンテーションなどの成果物を作成できるAIエージェントです。Claude Coworkも、外部のツールやデータソースを連携させながら業務を進める仕組みを提供しています。


こうしたOpenAIやAnthropicが提供するAIエージェントを、日常業務のフロントとして活用されている方も多いです。
実際に、私たちのお客様の中にも、フロントとしてChatGPT WorkやClaude Coworkを活用し、企業固有の業務ナレッジにKnow Narratorを活用いただき、組み合わせて利用されているお客様がいらっしゃいます。
企業の生成AI活用で重要なのは、このAIの仕組みで完結という話しではなく、AIエージェントのフロントと、企業固有のナレッジ基盤を分けて設計することです。
例えば、ChatGPT Workに次のような指示をしたとします。
「過去のXXに関する設計不具合と、最新のYY設計標準を調査し、材料変更の検討資料を作成して」
このとき、AIエージェントであるChatGPT Workが企業固有の情報をKnow Narratorから取得できれば、その情報をもとに分析や資料作成を進める構成を実現できます。
そのための接続方式として活用できるのがMCPです。
全体としては次のような構成です。

この構成では、フロントのAIエージェントが変わっても、企業固有の知識をKnow Narrator側で継続的に管理・活用することを目指せます。
また、外部のAIエージェントがKnow Narratorに接続する際には、利用者の認証、参照権限、情報の送信範囲、監査ログなどについても設計が必要です。
接続できることと、安全に業務利用できることは、別の問題です。
企業にとって大切なのは、どのAIの画面、どのAIエージェントを使うかだけではありません。そのAIが、自社の知識を正しく、適切な権限で活用できることなのです。
すべての社員が同じAIエージェントを使う必要はない
では、企業全体でAIエージェントを活用する場合、社員全員にChatGPTやClaude、MS Copilotの有償ライセンスを準備することが最適でしょうか?それで費用対効果は問題無いでしょうか?
企業の規模や、業種業態によって最適解は変わりますが、すべての社員にChatGPTやClaudeの有償ライセンスを用意するのではなく、利用頻度や業務内容に応じて、ライセンスの割り当てを行う事から考えてみてはいかがでしょうか?
例えば、AIを日常的に活用し、複雑な調査や分析、資料作成を行うパワーユーザーには、ChatGPTやClaude、MS CopilotなどのAIエージェントを利用してもらう。
一方で、一般社員には、組織の共通AI環境としてKnow Narrator AgentSourcingのような安価な仕組みを提供する。このように、社員の業務や利用状況に応じて、AIエージェントを使い分けるアプローチが考えられます。
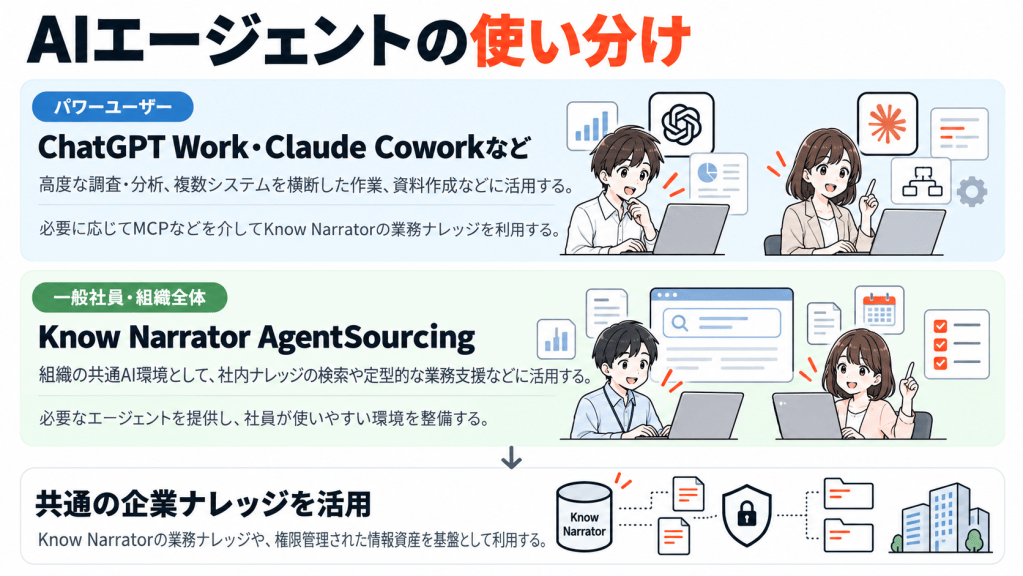
こうした使い分けによって、AIエージェントを使いこなす一部の社員だけでなく、より多くの社員がAIを業務で活用できる環境を目指せます。もちろん、どの社員にどのライセンスを割り当てるかは、利用頻度や業務内容、費用対効果を踏まえた検討が必要です。
重要なのは、全員が同じAI製品、AIエージェントを使うことではなく、それぞれの社員が、自分の業務に適したAIエージェントを利用できる環境を用意することだと考えています。
まとめ
今回は、RAGの回答品質について考えてきました。
ExcelやPowerPoint、PDFの情報を正しく読み取ることは重要です。しかし、それだけでは十分ではありません。必要な情報を検索できること。根拠に基づいて回答できること。条件や例外を正しく扱えること。そして、適切な権限のもとで情報を利用できること。さらに、企業の業務では、複数の業務ナレッジを横断したり、MCPを介して業務システムに接続したりすることも重要になります。これらを一つずつ実現していくことで、RAGは単なる社内文書検索から、企業の業務を支える知識基盤へと進化していきます。そして、AIエージェントが本格的に業務を遂行する時代には、その知識基盤の重要性はさらに高まると考えています。どれほど優秀なAIエージェントであっても、参照する企業の情報が不足していたり、間違っていたりすれば、適切な業務遂行は難しいからです。
我々電通総研AITCは、Know NarratorのマルチモーダルRAG、マルチ業務ナレッジ、そしてMCPによる外部システム連携を通じて、企業に蓄積された知識と業務システムを、さまざまなAIエージェントから活用できる基盤へと発展させていきたいと考えています。
その際、すべての社員がChatGPTやClaude、MS Copilotの有償ライセンスを持つ必要はありません。高度なAIエージェントを活用するパワーユーザーは、使い慣れたChatGPT WorkやClaude Coworkなどから、Know Narratorの業務ナレッジを活用する。一方で、そうしたライセンスを持たない社員には、組織の共通AI環境としてKnow Narrator AgentSourcingを提供する。企業のナレッジ基盤を共通化しながら、フロントのAIエージェントを社員の業務に応じて使い分ける。こうした構成によって、より多くの社員が、自社の固有データを利用したAIエージェントを活用できるようになり、企業全体のAI活用をさらに推進できると考えています。
- 「RAGを導入したものの、回答精度が上がらない」
- 「サイロ化されている複数部門のナレッジや業務システムを横断的に活用したい」
- 「ChatGPT WorkやClaude Coworkを個人の情報利用だけではなく、自社の業務ナレッジと組みあわせた組織としての利用を加速させたい」
- 「一部の社員だけでなく、組織全体でAIエージェントを活用したい」
このような課題をお持ちのお客様は、ぜひ電通総研AITCにご相談ください。
単なるRAGの精度改善にとどまらず、企業固有のナレッジをどのように整備し、MCPを通じて既存の社内システムと連携させ、AIエージェントによって実際の業務で活用していくのか。そして、パワーユーザーから一般社員まで、組織全体でAIを活用できる環境をどう実現するのか。
お客様の業務とデータ、業務システムを起点に、一緒に考えていきたいと思います。
企業の知識を、AIが読める情報にし、組織で仕事に生かせる力へ。
それが、私たちAITCがKnow Narratorを通じて実現していきたい世界です。
筆者
AITC センター長
深谷 勇次