
そのAI活用知識、誰が育て続けるのですか?AI時代の新職種「ナレッジエンジニア」とは
 fukayayuji

はじめに
AITCセンター長の深谷です。
ここ最近、本当に使えるRAGとは?という想いで、3回にわたって記事を書いてきました。
最初の記事では、横長の表や長文セルを持つExcelを、AIがどこまで読み取れるのか。

次の記事では、PowerPointやPDFに含まれる画像、グラフ、表、業務フローまで読み取る「マルチモーダルRAG」。
そして3本目では、資料をAIが読み取れるようにしたその先で、「そのRAG、本当に正しく答えていますか?」という、回答品質の問題を取り上げました。
ExcelやPowerPointやPDFの図表まで読める、複数の業務ナレッジや業務システムを横断し、利用者や業務に応じて適切な情報を使い分ける。
ここまで来ると、次の疑問が出てきます。
そのRAGや企業ナレッジを、誰が育て続けるのでしょうか?
RAGは、一度作ったら終わりではありません。むしろ、業務で本格的に利用し始めてからがスタートです。
今回は、これからのAI活用で重要になると私が考えている、「ナレッジエンジニア」という役割について考えてみたいと思います。
RAGは「作って終わり」ではない
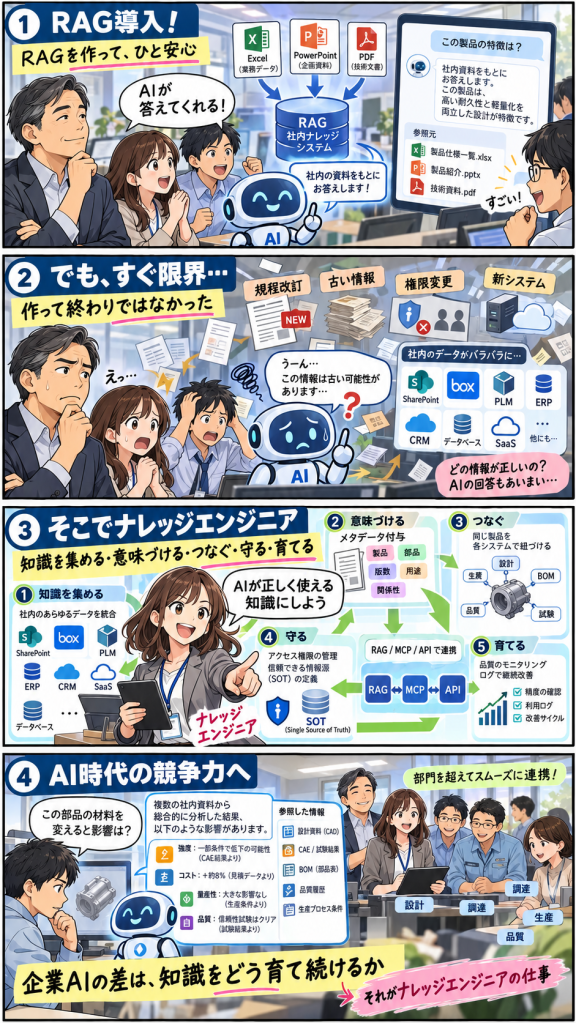
例えば、社内規程を検索するRAGを作ったとします。導入した時点では、最新の規程が登録され、質問にも正しく答えられていました。これは便利です。
しかし、半年後、1年後はどうでしょうか。
- 規程が改訂された
- 古い規程が残っている
- 新しい製品の情報が追加された
- 組織変更によってアクセス権限が変わった
- 新しい業務システムが導入された
- ユーザーが想定していなかった質問をするようになった
こうしたことは、企業では日常的に発生します。さらにAIエージェントの利用が広がれば、AIが参照する情報も、PDFやExcelだけではなくなります。
SharePointやBOX、PLM、CRM、ERP、データベース、各種SaaSサービスなどの業務システムをMCPやAPIを通じて、AIが直接業務システムへアクセスするケースも増えていくでしょう。
そうなると、企業AIで重要なのは、
どの情報を渡すのか、どの情報を正しい情報として扱わせるのか、どの情報同士を関連付けるのか、
誰にどこまで見せるのか、情報が古くなっていないか、本当に正しく答えられているのか。
こうしたことを継続的に考える役割が必要になります。
「ナレッジエンジニア」が改めて注目されている
実は「Knowledge Engineer」という言葉そのものは、新しいものではありません。
第二次AIブームだった1980年代のエキスパートシステムの研究でも、専門家が持つ知識を聞き出し、それをコンピュータが扱える知識ベースへ落とし込む人が「Knowledge Engineer」と呼ばれていました。
つまり、「人間の知識を、コンピュータが利用できる形にする」という仕事は、AIの歴史の中で以前から存在していました。
ところが2026年になって、この「Knowledge Engineer」という言葉が、生成AI・AIエージェントの文脈で改めて注目されています。
例えば、ドキュメントプラットフォームを提供するMintlifyは、まさに2026年9月に「Rise of the Knowledge Engineer」という記事を公開しています。

Forbes JAPANでも同じく2026年9月に、この動きを「新職種『ナレッジエンジニア』」として紹介しています。

私は、この流れは自然な流れかと思っています。なぜならば、生成AIの性能が上がれば上がるほど、
「AIそのものをどう作るか」だけではなく、「AIに何を知識として与えるか」
の重要性がより高まるからです。
「ナレッジエンジニア」とは
ナレッジエンジニアをどう捉えるかですが、私は、次のように定義したいと思います。
ナレッジエンジニアとは、「AIに何を、どの意味構造で、どの権限で、どの品質で使わせるか」を考え、部署を横断した企業のナレッジを、AIエージェントが理解・検索・推論・利用できる形に設計し、継続的に品質維持するエンジニア。
ポイントは、単に「データを整理する人」ではないことです。企業の中には、膨大な情報がいろいろな場所に、いろいろな形式で存在します。しかし、情報が存在していることと、AIがその情報を正しく利用できることは、まったく別です。
例えば、「製品A」という言葉一つを取っても、
- 営業資料の製品A。
- PLMに登録された製品A。
- ERPの商品コードとしての製品A。
- 品質管理システムに登録された製品A。
- 過去トラブル一覧に記載された製品A。
これらが同じ製品を指していることを、人間は業務知識によって理解できますが、AIにも同じように理解させようとすると、データを集めるだけでは足りません。意味や関係性を設計する必要があります。
ナレッジエンジニアの仕事は何か
ナレッジエンジニアの仕事を整理すると、大きく5つに分けられると考えています。
| 領域 | 主な仕事 |
|---|---|
| ① ナレッジを集める | 文書取り込み、Excel・PowerPoint・PDFの構造化、暗黙知の形式知化(データになっていないデータをデータ化する) |
| ② ナレッジに意味を与える | Metadata設計、用語統一、ID管理、データ間の関係設計、ナレッジグラフ |
| ③ AIとナレッジをつなぐ | RAG、MCP、API、業務システム連携、検索方式の設計 |
| ④ ナレッジを守る | 権限制御、Source of Truthの定義、セキュリティ、利用範囲の設計 |
| ⑤ ナレッジを育てる | 鮮度管理、AI回答評価、利用ログ分析、更新プロセス、継続的改善 |
どれも重要ですが、⑤ ナレッジを育てるまでやり続けないと、1つ前の節で定義した「ナレッジエンジニア」の仕事をしたとはなりません。
これまで、特に自社ユーザー向けの業務システムでは、「システムを作る」ことに大きな力を使い、運用開始したときがピークでした。
しかしAIでは、「AIが利用する知識を継続的に育てる」という活動が、これまで以上に重要になります。
昨日まで正しかった情報が、今日も正しいとは限りません。AIがどんな質問に答えられなかったのかを確認し、その原因が、
- 情報不足なのか
- 文書構造なのか
- Metadataなのか
- 検索なのか
- 権限なのか
- プロンプトなのか
- 未更新などの元データそのものなのか
を分析し、改善する。これがナレッジエンジニアの重要な仕事です。
例えば、製造業の設計部門ではどうなるか
少し具体的に考えてみましょう。
ある設計者がAIエージェントに、「この部品の材料を変更した場合、どんな影響がありますか?」と質問したとします。
この質問に本当に役立つ回答をするには、一つのExcel資料を検索するだけでは足りません。
例えば、現在の材料がなぜ選ばれたのかを知るための設計資料、変更による強度や耐久性への影響を確認するCAEや試験結果、製造工程への影響を判断する加工条件、さらに過去の不具合や類似部品の設計変更履歴などを見る必要があるかもしれません。
さらに、「この部品」とBOM上の部品番号を関連付けたり、要求と設計要素の関係をたどったりする必要もあります。PLMや品質システムの最新情報を取得するために、MCPやAPIを利用することもあるでしょう。
そして当然、利用者によって見せてよい情報も異なります。
つまり、AIエージェントに「この部品の材料を変更した場合、どんな影響がありますか?」という回答をさせるために、その回答が本当に業務で使えるものにするためには、上記に記載した、ナレッジエンジニアの仕事をすべて実施する必要があります。
RAGエンジニアとは何が違うのか
「それはRAGエンジニアでは?」と思われるかもしれません。
もちろん、RAGはナレッジエンジニアにとって非常に重要な技術です。しかし、対象範囲が違います。その他の近しいエンジニアと比べると以下のようになるかと思います。
| 役割 | 主に考えること |
|---|---|
| データエンジニア | データをどう収集・加工・蓄積・提供するか |
| AIエンジニア | AIモデルやAIアプリケーションをどう実装するか |
| RAGエンジニア | 必要な情報をどう検索し、LLMへ渡すか |
| 業務専門家 | 業務上、何が正しいのか |
| ナレッジエンジニア | AIが業務知識を正しく利用できる状態をどう作り、維持するか |
ナレッジエンジニアは、それぞれの間をつなぐ役割とも言えます。
業務を知らなければ、何が重要な情報か分かりません。データを知らなければ、情報を取得できません。AIを知らなければ、AIがどのような情報を必要とするか分かりません。そしてシステムを知らなければ、企業内で安全に運用できません。
だからこそ、ナレッジエンジニアは「AIだけ詳しい人」では成立しない職種だと考えられます。
「AI Ready Data」の、その先にある仕事
私はこれまで、「AI Ready Data」というテーマについて何度も記事を書いてきました。
AI Readyなデータ形式であるMarkdownやYAML、OKF(Open Knowledge Format)の記事も書いてきました。
これらの記事で繰り返しお伝えしてきたのは、AIにとって、情報は「ある」だけでは不十分ということです。
AIが迷わず利用できるように、構造化したり、意味を明示したり、出典を持たせたり、関係を表現したり、更新できるようにしたりする。
つまり、AIが利用できる形で提供する。これらを企業全体で考えることが、ナレッジエンジニアリングで、このナレッジエンジニアリング活動を、企業のナレッジ全体へ広げた役割が、ナレッジエンジニアとも言えます。
Know Narratorは「企業のナレッジエンジニアリング基盤」へ
この観点で考えると、私たちが開発しているKnow Narratorについても、単なるRAG製品として考えるだけでは足りないと思っています。
Know Narratorでは、Excel、PowerPoint、PDFなどの情報を取り込み、マルチモーダルRAGによって図表まで読み取り、複数の業務ナレッジから適切な情報を検索し、利用者や業務に応じて検索対象を制御する。
さらに、業務システムに存在する情報については、コネクターエージェントを通じて外部システムと連携する。
そして、利用ログを分析して回答品質を継続的に改善する。
こうした仕組みを組み合わせることで、「企業のナレッジをAIが安全に利用するための基盤」となります。
そして、この基盤を本当に機能させるには、ツールだけでは不十分です。
そこには、
- どのデータを登録するのか
- どの情報を正とするのか
- どのように分類するのか
- どことどこをつなぐのか
- 誰に利用させるのか
- どう品質を測るのか
を推進し続ける人が必要です。
つまり、プラットフォームと同時に、ナレッジエンジニアリングという業務そのものを企業に作っていく必要があります。
AIエージェント時代、企業の競争力は「知識の持たせ方」にも表れる
生成AIそのものは、今後も進化していくでしょう。
一方で、どの企業でも同じ生成AIが利用できる状況であれば、企業AIの差を生む要素の一つは、「その企業にしかない知識を、AIがどこまで正しく利用できるか」になります。
- 過去の設計判断
- 熟練者のノウハウ
- 顧客とのやり取り
- 失敗したプロジェクトから得た教訓
- 製造現場で積み上げられた経験
- 営業担当者が知っている顧客特有の事情
などなど、企業には、こうした知識が多く存在します。
これらを単にファイルサーバーに保存しておくのではなく、AIが理解し、検索し、必要に応じて組み合わせ、業務で利用できる状態にする。そこに、ナレッジエンジニアの大きな役割があります。
まとめ AI時代に必要なのは「AIが使う知識を育て続ける」こと
RAGを導入して文書を検索できるようにすることは、ゴールではありません。
生成AIやAIエージェントが業務の中に入っていけばいくほど、重要になるのは、AIにどの知識を与え、その知識をどのようにつなぎ、守り、そして育て続けるのかということです。
企業には、過去の設計判断や熟練者のノウハウ、顧客とのやり取り、過去の失敗から得た教訓など、その企業にしかない多くの知識があります。
しかし、それらが社内のどこかに「存在している」だけでは、AIは十分に活用できません。ナレッジエンジニアリングを継続して回していくことが、これからの企業AI活用では重要になってくると考えています。
そして、その中心となる役割が、今回紹介した「ナレッジエンジニア」です。
生成AIそのものがこれからも進化していき、同じ生成AIをどの企業も利用出来るようになった時、これからの企業AIの差は、「どのAIを使っているか」だけではなく、「自社の知識をAIがどこまで使える状態にできているか」にも表れてくると考えています。
私たち電通総研は、Know Narratorを単なるRAG製品ではなく、企業のナレッジエンジニアリングを支える基盤として進化させながら、お客様と一緒に、「企業の知識をAIが本当に使える状態にする」取り組みを進めています。
RAGを作って終わりではなく、企業の知識をAIとともに育て続ける。
そんなナレッジエンジニアリングの仕組みを、これから一緒に作っていければと思います。
筆者
AITC センター長
深谷 勇次
