100万トークンのAIがあれば、RAGは不要か?~大容量コンテキスト時代に考える企業AIとコストの最適解~
 fukayayuji

はじめに
AITCセンター長の深谷です。
最近の生成AIの進化は本当に驚かされます。GPT、Claude、GeminiなどのAIモデルは、推論能力が高くなっただけでなく、一度に読み込める情報量である「コンテキスト長」も大幅に拡大しています。最近では、100万トークン級のコンテキスト長を持つモデルも登場しています。
当サイトでも、生成AIモデルの最大トークン数を比較した記事を公開して、随時更新し続けていますが、多くの方に読んでいただいています。
各生成AIモデルの最大トークン数比較ガイド
はじめに 生成AIの性能や使い勝手を語るうえで欠かせない指標が、「コンテクスト長」「最大入力トークン」「最大出力トークン」です。これらの数値はモデルごとに大きく異…
 AITC | AI TRANSFORMATION CENTER

ところで、これだけ大量の情報をAIが一度に読み込めるようになると、こんな疑問が出てきませんか?
「100万トークンも読めるなら、わざわざRAGを構築する必要はないのでは?」
RAG(Retrieval-Augmented Generation:検索拡張生成)は、質問に関係する情報を検索し、その情報をAIに渡して回答を生成する技術です。
しかし、大量の資料をAIに直接渡せるのであれば、検索する必要もなくなるように感じます。
実際、利用する資料が少なく、対象が明確な場合には、RAGを使わずにAIへ直接資料を渡す方が適しているケースもあります。
では、企業全体で生成AIを活用する場合はどうでしょうか?
今回は、AIの「大容量コンテキスト」と「RAG」の違いを整理しながら、特に回答品質とコストの観点から、企業AIの最適な構成を考えてみたいと思います。
100万トークンのAIは、何がすごいのか?
コンテキスト長とは、AIが一度の処理で扱える情報量の上限です。
例えば、OpenAIのGPT-6.1 Solは、約105万トークンのコンテキストウィンドウに対応しています(2026年10月時点)。
トークンと文字数は一致しませんが、非常に大量の文章を一度に扱える規模です。300ページの日本語の文庫小説は、約12万〜18万文字、AIのトークン数では約12万〜24万トークンと見積もれます(日本語のトークン数は、使用するAIモデルのトークナイザーによって異なります)。
企業の業務で考えると、従来は分割して処理する必要があった長い契約書や技術資料、プログラムのソースコードなどを、まとめてAIに読み込ませられるケースが増えてきました。
例えば、次のような業務です。
- 数百ページに及ぶ契約書を読み込み、条項間の矛盾を確認する
- 複数の法規・規格を読み込み、それぞれの要求事項を比較する
- 複数の議事録をまとめて読み込み、意思決定の経緯を整理する
- 大規模なソースコードを読み込み、処理の依存関係を調査する
これらの業務では、関連する情報をあらかじめ絞り込まず、全体をAIに渡すことに意味があります。特に、文書全体の整合性を確認したり、離れた箇所の記述を突き合わせたりする業務では、大容量コンテキストが有効です。
つまり、大容量コンテキストの進化によって、RAGを使わなくても実現できる業務は確実に増えています。
ただし、ここで注意したいことがあります。
それは、「大量の情報を読み込めること」と「大量の情報から正しく答えられること」は、必ずしも同じではないということです。
大量の資料をAIに渡せば、正しい回答が得られるのか?
例えば、ある製品開発部門の担当者が、AIに次のような質問をしたとします。
「この設計変更は、どの法規・規格に影響する?」
企業の中には、この質問に答えるためのさまざまな情報が存在しています。
- 国内外の法令・規制に関する資料
- ISOやIECなどの国際規格
- 業界ごとの技術基準・ガイドライン
- 社内の設計基準や品質基準
- 過去の法規・規格への適合性確認記録
- 製品仕様書や設計変更に関する資料
これらの資料をすべてAIに渡せば、答えが得られそうです。
しかし、実際には簡単ではありません。
例えば、同じ製品でも、販売する国や地域によって適用される法規が異なる場合があります。また、ある規格の旧版では問題なかった変更でも、最新版では要求事項が変わっているかもしれません。過去の類似製品では適用されなかった規制が、今回の製品には適用される可能性もあります。さらに、規格の本文だけでは判断できず、別の規格を参照しなければならないケースも考えられます。
つまり、AIには単に資料を読むだけではなく、今回の設計変更に関係する法規・規格はどれか、どの版が有効なのか、どの条件で適用されるのかを正しく整理してもらう必要があります。
また、長いコンテキストに含まれる情報の位置によって回答性能が変化する「Lost in the Middle」という問題も研究されています。
これは、長文の中央付近にある重要な情報を、AIが十分に利用できない場合があるという現象です。
もちろん、2026年現在のAIモデルは進化しており、以前の研究結果がそのまま最新モデルに当てはまるわけではありません。それでも、コンテキスト長の上限だけで回答品質を保証できないことは、意識しておく必要があります。
[2307.03172] Lost in the Middle: How Language Models Use Long Contexts
While recent language models have the ability to take long contexts as input, relatively little is known about how well they use longer context. We analyze the…

法規・規格のような情報では、これが特に重要です。
似た規格を見つけられたとしても、適用される製品や条件を誤ってしまえば、業務上は正しい回答になりません。
また、法規・規格の適用可否については、AIの回答をそのまま最終判断とせず、原文や最新版を確認したうえで、担当者や専門家が判断する必要があります。
AIには、その判断を支援するために、確認すべき法規・規格の候補と、関係する条項、その根拠を提示してもらうことが重要なのです。
そして、もう一つ重要な問題があります。コストです。
100万トークンを毎回AIに渡したら、いくらかかるのか?
ここからは、具体的に計算してみましょう。
例として、OpenAIのGPT-6.1 Solを利用する場合を考えます。
2026年10月24日時点の標準API料金は、100万トークンあたり以下のとおりです。
| 課金項目 | 27.2万入力トークン以下 | 27.2万入力トークン超 |
|---|---|---|
| 入力 | $2.00 | $4.00 |
| キャッシュ済み入力 | $0.10 | $0.20 |
| 出力 | $10.00 | $15.00 |
注意したいのは、GPT-6.1 Solでは、入力が27.2万トークンを超えると、そのリクエスト全体に長文向けの料金が適用されるという点です。
単に入力トークン数が増えるだけでなく、適用される単価も変わります。
ケース1:大量の社内資料をすべてAIに渡す場合
先ほどの「この設計変更は、どの法規・規格に影響する?」という質問を考えてみましょう。
関連する法規・規格、社内基準、過去の確認記録などを大量にAIへ渡す構成です。
次の条件を想定します。
- 利用モデル:GPT-6.1 Sol
- 1回の入力:90万トークン
- 1回の出力:2,000トークン
- プロンプトキャッシュ:利用しない
- 月間利用回数:10,000回
1回の処理コストは、
入力:90万 ÷ 100万 × $4.00 = $3.60
出力:2,000 ÷ 100万 × $15.00 = $0.03
合計 $3.63/回 です。
1ドル=150円と仮定すると、約545円になります。
これを月間10,000回実行すると、月額約544.5万円です。
AIへの質問1回で約545円というのは、一般的な社内問い合わせ用途としては、なかなか大きな金額ではないでしょうか。
ケース2:RAGで必要な情報だけ検索してAIに渡す場合
今度は、同じ質問に対してRAGを利用する場合を考えます。
あらかじめ社内の法規・規格関連資料を検索できるようにしておき、質問に関係する情報だけを取得します。
例えば、設計変更の内容や製品の適用地域などを手がかりに、関係する法規・規格の条項、社内基準、過去の確認結果などを取得します。
その結果、AIに渡す入力を2万トークンに抑えられたとします。
- 利用モデル:GPT-6.1 Sol(同じモデル)
- 1回の入力:2万トークン
- 1回の出力:2,000トークン
- プロンプトキャッシュ:利用しない
- 月間利用回数:10,000回
1回の処理コストは、
入力:2万 ÷ 100万 × $2.00 = $0.04
出力:2,000 ÷ 100万 × $10.00 = $0.02
合計 $0.06/回 です。
1ドル=150円の仮定では、約9円になります。
これを月間10,000回実行すると、月額約9万円です。
比較してみると?
| 比較項目 | 大容量コンテキスト | RAG |
|---|---|---|
| 1回の入力トークン | 900,000 | 20,000 |
| 1回の出力トークン | 2,000 | 2,000 |
| AI処理費用/回 | 約545円 | 約9円 |
| 月間10,000回 | 約544.5万円 | 約9万円 |
| 費用比率 | 約60.5倍 | 1倍 |
※上記は指定した条件での試算です。実際のトークン使用量や為替、キャッシュ利用状況などによって変動します。また、RAG側の検索基盤やインデックス、運用費用は含んでいません。
この差は非常に大きいと思います。
もちろん、すべての業務で90万トークンを毎回入力するわけではありませんし、RAGでも常に2万トークンで回答できるわけではありません。
また、RAGで必要な法規・規格を検索できなければ、安くても意味がありません。
それでも、企業全体で何万回、何十万回とAIを利用することを考えると、AIに渡す情報を適切に絞り込むことが、コスト最適化に直結することは理解いただけると思います。
プロンプトキャッシュがあれば、大容量コンテキストでも安くなるのでは?
ここまで読んで、詳しい方はこう思われるかもしれません。
「最近のAIにはプロンプトキャッシュがあるので、同じ資料を繰り返し渡しても安くなるのでは?」
それは、そのとおりです。
プロンプトキャッシュは、同じ入力内容の一部を再利用することで、AIの処理コストや応答時間を削減する仕組みです。
例えばGPT-6.1 Solでは、27.2万トークンを超える長文リクエストの場合でも、キャッシュ済み入力の単価は100万トークンあたり$0.20です。
先ほどの90万入力トークンがすべてキャッシュにヒットしたと仮定すると、
入力:90万 ÷ 100万 × $0.20 = $0.18
出力:2,000 ÷ 100万 × $15.00 = $0.03
合計 $0.21/回 になります。
これは、約31.5円に相当します。
先ほどの約545円と比べると、大幅に安くなります。
ただし、これはキャッシュがすでに作成され、入力全体を再利用できた場合の理想的な試算です。
実際には、キャッシュを利用するために次の点に注意が必要です。
- キャッシュへの書き込みにも料金が発生する
- キャッシュには保持期間や再利用条件がある
- 毎回異なる資料や質問が含まれると、期待するキャッシュヒット率を得られない場合がある
- 法規や規格の改訂によって資料が更新されれば、変更された部分を再処理する必要がある
GPT-6.1 Solでは、標準の30分キャッシュに加え、12時間のキャッシュ保持も選択できますが、保持方式によって書き込み単価が異なります。
Learn how prompt caching reduces latency and cost for long prompts in OpenAI
つまり、プロンプトキャッシュは非常に有効なコスト削減技術ですが、すべての企業データをいつでも安く読み込ませられるというわけではありません。
一方、RAGも無料で実現できるわけではありません。
文書の取り込み・解析、Embeddingによるベクトル化、検索インデックス、検索基盤、再ランキング、データ更新などの費用がかかります。さらに、AIエージェントが質問を分解して何度も検索したり、複数回のLLM呼び出しを行ったりすれば、その分のコストも発生します。
例えば、先ほどのRAGによるAI処理費用9円に、検索などの処理費用として仮に1回10円を加えれば、合計19円です。月間10,000回なら19万円になります。
これは説明用の仮定ですが、RAGの検索費用も含めた比較が必要であることが分かります。
また、キャッシュヒット率が非常に高く、対象文書も固定されている場合には、大容量コンテキストの方がシンプルで経済的になるケースも考えられます。
そのため、本当に比較すべきなのは、LLMの入力トークン料金だけではなく、検索や運用も含めた業務1件あたりの総コストです。さらに言えば、同じ品質の回答を得るために、どれだけの費用がかかるのかを比較するべきです。
企業でAIを本格活用するなら、この視点は欠かせないと思います。
コスト以外にも、企業がRAGを必要とする理由がある
大容量コンテキストとRAGの違いは、コストだけではありません。
企業での活用を考えると、もう少し本質的な問題があります。
① 企業の知識は、100万トークンには収まらない
企業には、膨大な情報が存在しています。
何万件もの契約書、設計資料、営業提案書、顧客対応履歴、社内規程などです。
また、法規や規格のように、対象の国や地域、製品分野、改訂版ごとに参照すべき情報が異なるものもあります。
一度に読める情報が100万トークンになったとしても、企業全体の知識と比較すれば、その一部分にすぎません。
さらに、それらの情報は日々更新されていきます。
そのため、重要になるのは「すべてをAIに渡すこと」ではなく、必要なときに、必要な情報を取り出せることです。
② 誰が、どの情報を使ってよいのか?
例えば、ある社員がAIに質問したとき、他部門の機密情報や人事情報までAIに渡されてしまっては困ります。
また、同じ製品に関する情報でも、開発プロジェクトや担当部門によって参照可能な範囲が異なる場合があります。
大容量コンテキストを利用する構成でも、適切な権限チェックを実装することは可能です。
ただし、企業全体の膨大な情報から毎回アクセス可能な資料を選別して渡すのであれば、検索対象や利用権限を管理する仕組みが必要になります。
RAGを中心とした企業ナレッジ基盤は、このような情報管理との組み合わせに適しています。
もちろん、RAGを導入するだけでセキュリティが保証されるわけではなく、認可や情報の分離を適切に設計する必要があります。
③ 企業の知識は、文書だけに存在するわけではない
もう一つ、重要なポイントがあります。
企業の情報は、PDFやExcel、PowerPointだけに存在しているわけではありません。
例えば、最新の製品情報は製品管理システムに、顧客情報はCRMに、取引情報はERPに存在しているかもしれません。
法規・規格に関しても、最新版の確認や改訂情報の取得が必要な場合があります。
AIエージェントが業務を遂行するには、文書検索だけでなく、こうした業務システムや外部情報源から、必要な情報を取得して組み合わせることも重要になります。
例えば、先ほどの「この設計変更は、どの法規・規格に影響する?」という質問なら、社内の法規対応記録をRAGで検索し、現在の製品仕様を業務システムから取得し、法規・規格の最新状況を確認する、といった使い分けです。
その接続手段として、MCPやAPIを利用することが考えられます。
なお、外部の法規・規格情報については、情報源の信頼性や利用許諾、最新版であることの確認も欠かせません。
これは、AIが一度に何トークン読めるかという問題とは、別の話です。
企業のAI活用では、情報量だけではなく、情報の意味・鮮度・権限・取得先を管理することが必要なのです。
大容量コンテキストとRAGは、どう使い分ければよいのか?
ここまで考えると、大容量コンテキストとRAGは、どちらか一方を選ぶものではないと分かります。
私は、業務の特性に応じて、次のように使い分けることがよいと考えています。
| 利用シーン | 適した方式 | 理由 |
|---|---|---|
| 特定の契約書全体をチェックする | 大容量コンテキスト | 文書全体の関係性を見る必要がある |
| 限られた法規・規格を詳細に比較する | 大容量コンテキスト | 全文の情報を直接使いやすい |
| 大量の社内規程から必要な条文を探す | RAG | 必要な箇所を検索して利用できる |
| 設計変更に関連する法規・規格の候補を調べる | RAG | 多数の情報から関連する規定を絞り込める |
| 複数部門の情報を使って判断する | RAG+AIエージェント | 必要な情報源を横断できる |
| 業務システムの最新情報を参照する | MCP/API+AIエージェント | 必要な時点の情報を取得できる |
| 検索した複数資料を詳細に比較する | RAG+大容量コンテキスト | 必要な資料を選択し、まとめて分析できる |
特に、最後の組み合わせが重要だと思います。
まずRAGで必要な資料を検索する。
次に、その資料を大容量コンテキストのAIに渡して、詳細に分析させる。つまり、RAGで必要な情報を絞り込み、大容量コンテキストで深く考えさせる。
こうした構成であれば、それぞれの技術の強みを活用できます。
ただし、RAGで重要な情報を検索し損ねれば、後段のAIが高性能でも正しい回答はできません。
例えば、ある設計変更に関連する規格が複数存在しているのに、そのうち一つしか検索されなかったとします。その場合、AIが検索された規格について正しく説明していても、回答全体としては不十分です。逆に、必要な規格を検索できていても、適用する地域や製品の条件を取り違えれば、正しい判断にはつながりません。
したがって、実際に導入する際には、回答品質、検索漏れ、応答時間、総コストを業務ごとに比較することが重要です。
企業のAI活用では、Know NarratorのようなAIのためのナレッジ基盤が重要
私たち電通総研が提供するKnow Narratorでは、企業固有の知識をAIが活用するための仕組みを提供しています。
特に、Know Narrator Searchでは、文書やExcel、PowerPoint、PDFなどに含まれる企業固有の情報を業務ナレッジという形で、AI Ready Data化し、RAGで活用できます。
そのRAG、本当に正しく答えていますか?~Excel・PowerPoint・PDFを読み取った、その先にある「回答品質」の壁~
はじめに AITCセンター長の深谷です。 前回、前々回のコラムでは、企業に蓄積されたExcelをRAGで活用する方法や、PowerPoint・PDFに含まれる画像、グラフ、表まで理解する…
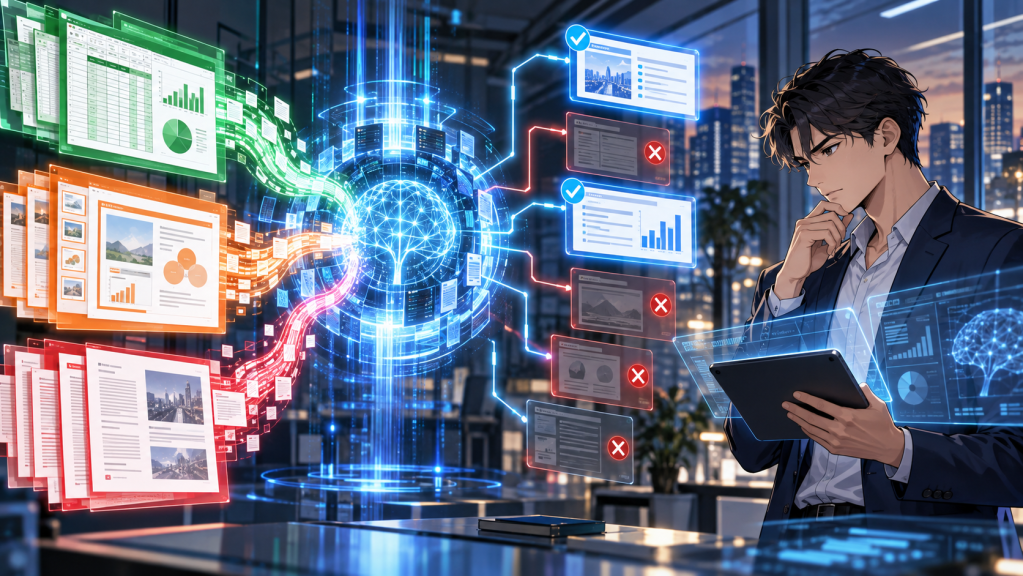
また、Know Narrator AgentSourcingでは、質問内容に応じて複数の業務ナレッジを自動的に選択し、横断検索して統合した回答を生成する「マルチRAGエージェント」を提供しています。
この仕組みで重視しているのは、単に大量の資料をAIに読ませることではありません。
今回の質問に対して、どの業務ナレッジを参照するべきかを判断し、必要な情報をAIに渡すことです。
例えば、「この設計変更は、どの法規・規格に影響する?」という質問であれば、法規・規格の関連資料、製品ごとの基準、過去の確認記録などを中心に検索することが考えられます。
一方、人事部門からの質問であれば、人事規程や労務関連資料を中心に検索する。
営業部門からの質問であれば、提案資料や製品情報を中心に検索する。
このように、業務に応じて適切な情報を選択することが重要です。
必要な場合には複数の業務ナレッジを横断しますが、関係のない情報は検索対象から外す。
この「情報の足し算と引き算」が、回答品質だけでなく、AIに渡す情報量や処理コストの最適化にもつながると考えています。
また、私たちが目指しているのは、Know NarratorだけですべてのAI処理を完結させることではありません。
ChatGPTやClaudeなどのAIエージェントをフロントとして利用し、その背後にある企業固有の業務ナレッジをKnow Narratorから取得する構成も重要です。
さらに、Know Narrator AgentSourcingでは、MCPを介して外部システムと接続するためのコネクターエージェント機能も提供しています。
これにより、社内文書の検索だけではなく、業務システムからの情報取得も組み合わせたAI活用が可能になります。
AIモデルは今後も進化し、コンテキスト長もさらに拡大していくでしょう。
だからこそ、企業固有の知識を、特定のAIモデルに依存せずに利用できる状態にしておくことが大切だと考えています。
まとめ:AIが読める情報量ではなく、AIに何を読ませるかが重要になる
100万トークン級のコンテキスト長を持つAIの登場によって、生成AIの活用範囲は大きく広がっています。
そして今後、コンテキスト長がさらに拡大し、処理コストも下がっていけば、RAGを使わずに実現できる業務は増えていくでしょう。
しかし、企業のAI活用で重要なのは、単に大量の情報をAIに読ませることではありません。
- どの情報が必要なのか。
- 情報は最新で、今回の業務に適用できるのか。
- 誰が利用してよい情報なのか。
- その情報をAIに渡すために、どれだけのコストがかかるのか。
こうしたことを考え、AIに利用させる情報を適切に設計することが必要です。
大容量コンテキストによって、AIはより多くの情報を読めるようになりました。
一方で、RAGやMCPなどの技術によって、企業はAIに必要な情報を適切に届けることができます。
そして、その情報をどのように整備し、継続的に育てていくのかという、ナレッジエンジニアリングの重要性も高まっていくと考えています。
そのAI活用知識、誰が育て続けるのですか?AI時代の新職種「ナレッジエンジニア」とは
はじめに AITCセンター長の深谷です。 ここ最近、本当に使えるRAGとは?という想いで、3回にわたって記事を書いてきました。 最初の記事では、横長の表や長文セルを持つEx…
私は、これからの企業AI活用でより重要になるのは、AIが「どれだけ多くの情報を読めるか」ではなく、「必要なときに、必要な企業知識を、正しく、効率よく利用できるか」だと考えています。
私たち電通総研では、Know Narratorを通じて、企業の業務ナレッジの整備から、RAGによる情報検索、AIエージェントによる業務活用までをご支援しています。
「大容量コンテキストとRAGをどう使い分けるべきか」「社内の生成AI利用コストをどう見える化するか」「自社の情報をAIエージェントにどう活用させるか」
こうした課題をお持ちのお客様は、ぜひ電通総研AITCにご相談ください。自社の知識を最大限に活用できる仕組みを、一緒に考えていければと思います。
筆者
AITC センター長
深谷 勇次